


Dataanalyser i revisjon – metodikken
Dataanalyser i revisjon, Audit Data Analytics, handler om å bearbeide informasjon på en slik måte at vi kan finne sammenhenger, mønstre og relasjoner i datamaterialet. Men hvordan kan vi ta dette i bruk i praksis, når bruk av dataanalyser ikke er omtalt i standardverket?
I de to foregående artiklene i serien har vi sett hvordan vi kan skape verdifull innsikt og forståelse basert på de store mengdene data som genereres i dagens virksomheter, og hvordan vi kan utnytte dette i revisjon. Denne artikkelen fokuserer på hvordan vi i praksis går frem når vi bruker dataanalyser i risikovurderingshandlinger eller til å innhente revisjonsbevis. Metodikken som presenteres baserer seg på AICPA sin veiledning for dataanalyser i revisjon.
5-stegsmodell
Prosessen med å gjennomføre dataanalyse i revisjon kan deles inn i fem steg, og vi vil i denne artikkelen gi en kort innføring i hva det er viktigst å ha fokus på i de ulike stegene.
Steg 1: Planlegging
Prosessen starter med å legge en plan for dataanalysen vi skal gjennomføre. Det viktigste i denne fasen er å fastsette formålet med handlingen, og dermed hvilken type dataanalyse vi skal benytte.
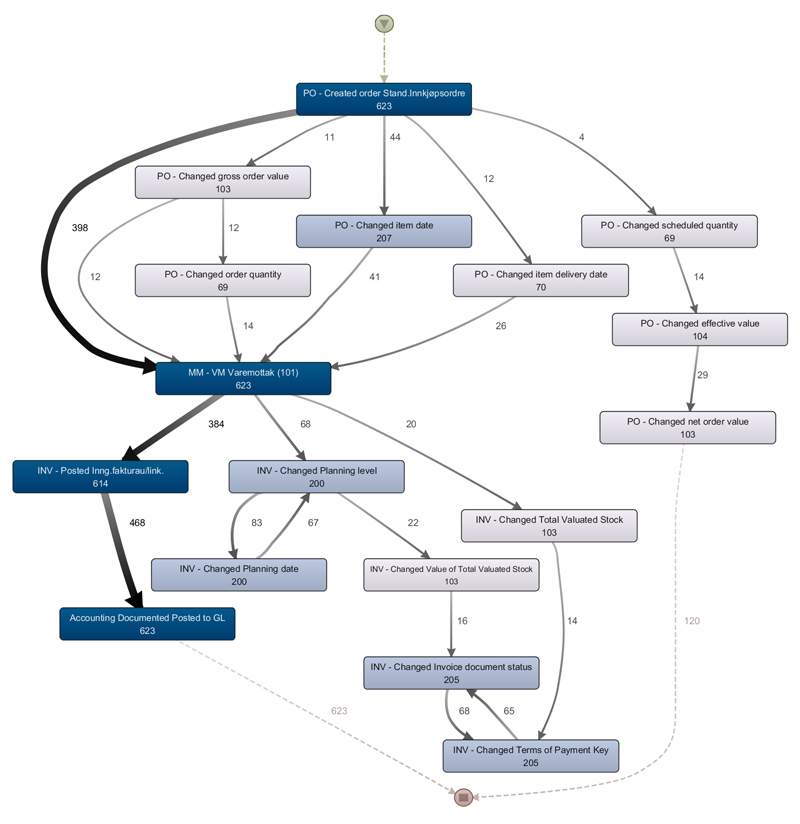
Figur 1 – Kartlegging av prosesser med bruk av process mining
Dataanalyse i risikovurdering
Den ene typen dataanalyse er de vi bruker i risikovurderingen, enten i planleggings- eller avslutningsfasen av revisjonen. Som revisor skal vi gjennomføre analytiske handlinger som en del av risikovurderingen, jf. ISA 315. Disse analysene utføres gjerne på et overordnet nivå, og gir kun en generell, første indikasjon på om det foreligger en risiko. Med dataanalyser kan vi identifisere risikoer langt mer presist. Et eksempel kan være en analyse utført på virksomhetens salg. Med tilgang til riktig type data, kan en dataanalyse gi oversikt over dekningsgrad pr. produkt pr. måned sammenlignet mot tidligere år, hvor større endringer kan indikere mulig risiko.
Et noe mer avansert eksempel er kartlegging av en hel forretningsprosess fra A til Å gjennom såkalt process mining, der vi kan se typen handlinger som er utført, når disse er utført og hvem som har utført dem. Ettersom metoden baserer seg på samtlige transaksjoner som har gått gjennom en prosess, kan vi få et fullstendig bilde av faktisk flyt. Sammenlignet med en muntlig gjennomgang med kunden, vil denne metoden gi en mer presis forståelse av prosessene hos kundene våre og et tydeligere risikobilde.
Dataanalyse til innhenting av revisjonsbevis
Den andre hovedtypen dataanalyser, er de dataanalysene vi bruker for å innhente revisjonsbevis. En mulighet er å bygge videre på dataanalysen utført i risikovurderingsprosessen. I eksempelet med process mining, kan det være aktuelt å bygge ut analysen til å erstatte en tradisjonell test av kontroll, ved å kontrollere om alle inngående fakturaer attesteres i henhold til virksomhetens attestasjonsmatrise. Videre kan vi gjennom dataanalysen også se på konteringen av de inngående fakturaene, og få oversikt over eventuelle konteringer som fremstår som unormale, for eksempel kontering på kontoer som normalt ikke forbindes med inngående fakturaer.
En annen mulighet er å bygge opp dataanalyser utelukkende for å innhente revisjonsbevis. Dette kan for eksempel gjøres ved å bruke dataanalyser til å sammenstille alle fraktdokumenter fra lagersystemet med tilhørende utsendt salgsfaktura for å få bevis for inntektenes fullstendighet og nøyaktighet.
Forholdet mellom dataanalyser og tradisjonelle revisjonshandlinger
Dataanalyse som metode for å innhente revisjonsbevis er ikke omtalt i standardene, og kan medføre usikkerhet rundt hvilke krav som stilles til innhenting av revisjonsbevis med denne metoden. Den praktiske tilnærmingen til dette er at vi vurderer om dataanalysen har mest til felles med detaljtester eller analytiske substanshandlinger, og følger de kravene standardverket gir for den aktuelle metoden. Det vil si at når vi utfører en dataanalyse som en analytisk substanshandling, må vi tallfeste forventning og fastsette et akseptabelt avvik. Dette gjør vi ikke dersom dataanalysen utføres som en detaljtest. Hvorvidt dataanalyser kan gjennomføres som en test av kontroll, omtales ikke i AICPA sin håndbok. For enkelte tester av kontroller, slik som i eksempelet med process mining, antas det at vi kan bruke dataanalyse utført som en detaljtest til å verifisere at kontrollen faktisk er utført hver eneste gang.
I planleggingsprosessen inngår også vurdering av hvilke spesifikke dataanalyseteknikker og verktøy vi antar er hensiktsmessige å benytte for å oppfylle formålet. I mange tilfeller vil vi komme langt med analyser som kan settes opp i Excel, så lenge vi har tilgang på egnet data.
Steg 2: Innhente data
Et kritisk punkt i prosessen videre er å velge ut og klargjøre data som skal benyttes, enten til risikovurdering, detaljtest eller som grunnlag for revisors forventning. Som omtalt i forrige artikkel i serien kan tilgang på data og strukturering av denne til analyseformål medføre en del utfordringer. Dersom vi skal gjennomføre en type dataanalyse som vi ikke har utført tidligere, vil det ofte være nødvendig å veksle mellom steg 1 og 2 flere ganger før vi har samsvar mellom analysens formål, og de dataene vi har tilgjengelig.
Steg 3: Vurdere dataenes relevans og pålitelighet
Når vi har innhentet data, er neste steg å vurdere relevansen og påliteligheten til disse dataene.
Vi må sikre at dataene vi benytter er relevante for formålet og kan gi oss bevis for de påstandene vi ønsker å dekke gjennom handlingen. Ved bruk av dataanalyser er det særlig viktig å være bevisst på de begrensningene som kan ligge i å kun benytte kundens interne data. Selv med tilgang til 100 % av all relevant data fra kunden, må det vurderes om vi oppnår tilstrekkelig sikkerhet uten bruk av ekstern data eller verifisering mot tredjepart. Fokus på testretning for å dekke opp henholdsvis eksistens og fullstendighet er fremdeles like viktig som ved tradisjonelle revisjonsmetoder.
Videre må vi vurdere om vi kan stole på dataene vi har hentet inn. Dette gjør vi også når vi bruker tradisjonelle revisjonsmetoder, og er således ikke noe nytt. Med stadig nye muligheter til å hente inn større mengder data, også fra eksterne kilder, er det viktig å ha fokus på dette. Ved bruk av data fra kundens interne systemer, vil fokuset gjerne være på dataenes fullstendighet. I hvilken grad vi kan stole på data som kunden produserer, dekker vi gjennom egne handlinger opp mot virksomhetens IT-miljø. Når det gjelder bruk av eksterne data, må det vurderes om dataene kommer fra en kilde vi kan stole på, og hva det opprinnelige formålet med dataene er. For eksempel kan data fra Altinn være relevant for revisjon av skyldige offentlige avgifter og lønn, men vi må samtidig huske på at data fra denne kilden bygger på hva virksomheten selv har rapportert inn til Altinn. Det opprinnelige formålet med data som Altinn har hentet inn, er ikke sammenfallende med formålet vi har ved innhenting av revisjonsbevis, og det må derfor gjøres en vurdering av om data fra denne kilden vil gjøre det mulig å oppnå formålet med dataanalysen.
Steg 4: Gjennomføre dataanalysen
Dersom vi kan gå god for dataenes relevans og pålitelighet, kan vi begi oss ut på gjennomføring av selve dataanalysen, og oppfølgingen av de avvikene som dataanalysen eventuelt gir.
Dersom dataanalysen gjennomføres som en analytisk substanshandling, vil dette steget omfatte arbeidet med å komme frem til revisors forventning, for eksempel basert på trendanalyser, nøkkeltallsanalyser eller regresjonsanalyse. Vurderingen av forventning opp mot faktisk bokført, gjøres i steg 5.
For andre dataanalyser gjennomføres en testing av 100 % av relevante data, sett opp mot formålet. Når vi benytter oss av 100 % av relevante data, gjerne tusenvis av transaksjoner, må vi forvente å avdekke flere avvik enn ved utvalgsbasert testing. Hvordan forholder vi oss så til disse avvikene, når én enkelt test kan avdekke flere avvik enn hva som er overkommelig å kontrollere manuelt?
Hvis de første resultatene indikerer at analysen ikke er korrekt designet eller gjennomført, må vi gjøre justeringer i analysen før vi prøver på nytt. Spesielle eller rare resultater kan indikere at vi ikke har forstått prosessene og rutinene hos kunden på en god nok måte, og en ny gjennomgang med kunde kan være nødvendig. Gode dataanalyser krever gjerne god forståelse av kunden, og arbeidet med å designe en dataanalyse som fungerer etter formålet, vil ofte bidra til å øke vår kunnskap om kunden.
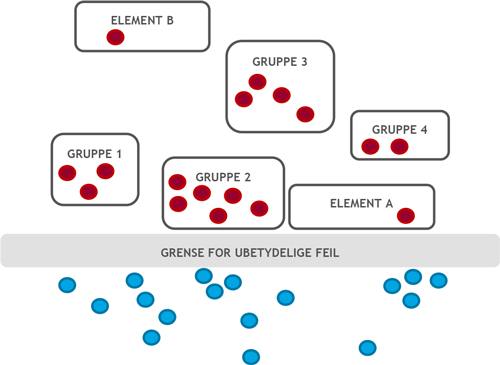
Figur 2 – Gruppering av avvik
Når vi kan konkludere med at dataanalysen er designet og gjennomført på en hensiktsmessig måte, blir neste steg å vurdere de avvikene vi eventuelt har avdekket. Ved et høyt antall avvik, vil den mest aktuelle fremgangsmåten være å gruppere avvikene med like kjennetegn, og se hver gruppe som en helhet for å få en bedre oversikt over avvikene. I eksempelet der vi sammenstiller fraktdokumenter fra lagersystemet med salgsfaktura, kan avvik eksempelvis grupperes ut fra om de gjelder samme kunde, samme vare eller samme dato. Det vil da være lettere å vurdere hvilke avvik som må følges opp nærmere, og hvilke som er såkalte falske positiver. Mange avvik på samme dato kan for eksempel indikere IT-problemer, og vi bør muligens gjøre spesifikke handlinger på denne datoen. Avvik for samme type vare trenger derimot ikke å indikere noen faktiske avvik. Kan det være at salg av en bestemt type vare behandles på en annen måte enn vi trodde? Kan det være transaksjoner som flyter på en annen måte enn vi forventet? Avdekking av disse forholdene vil kunne øke vår kunnskap om kunden, men vil normalt ikke indikere feil i regnskapet.
Gjennom gruppering kan vi få forklart en stor andel av avvikene vi har avdekket. Men hva med avvikene vi ikke får forklart? Dersom vi har gjennomført en dataanalyse i risikovurderingsfasen, vil avvikene gjerne representere nye risikoer eller risikoer som er høyere enn vi tidligere hadde vurdert. De kan gi oss nyttig informasjon når det gjelder å utforme revisjonshandlinger for å håndtere risikoen. Om vi har gjennomført dataanalyse for å innhente revisjonsbevis, vil avvikene vi ikke får forklart behandles på samme måte som avvik avdekket gjennom tradisjonelle revisjonshandlinger. De kan representere tallfestet feilinformasjon i regnskapet, eller vi kan være nødt til å utføre ytterligere revisjonshandlinger for å avdekke om det er feilinformasjon i regnskapet.
Steg 5: Vurdere resultatene og konkludere
Siste steg er å vurdere resultatene av dataanalysen. Har vi oppfylt formålet med dataanalysen? Har vi oppnådd den sikkerheten vi ønsket, og for de påstandene vi hadde til hensikt å teste. Har vi avdekket vesentlige avvik? Dersom dataanalysen er gjennomført som en analytisk substanshandling, er avviket mellom vår forventning og faktisk bokført beløp høyere enn hva vi kan akseptere? Svar på disse spørsmålene vil bringe oss frem til konklusjonen på dataanalysen, og avgjøre i hvilken grad vi må gjøre ytterligere handlinger for å oppfylle formålet.
Avsluttende kommentarer
Den overordnede fremgangsmåten ved å bruke dataanalyser i revisjon er som vi ser ikke så ulik hvordan vi går frem i øvrige revisjonshandlinger vi utfører. Dataanalyser er i bunn og grunn bare en annen måte å gjennomføre risikovurdering eller innhente revisjonsbevis på, og kan ofte grense nært opptil de tradisjonelle metodene som benyttes. Formålet med revisjonen er fremdeles det samme, og den kunnskapen vi har med oss fra bruk av tradisjonelle revisjonsmetoder er derfor i høyeste grad relevant og overførbart til bruken og vurderingen av dataanalyser i revisjon. Samtidig må vi innse at det teknologiske skiftet også treffer revisjonsbransjen, og teknologisk kompetanse har blitt en viktig del av hverdagen vår som revisor. Vi må våge å ta den i bruk.
Les videre: AICPA (2017) – Guide to Audit Data Analytics


