


ESEF – En teknisk gjennomgang for ikke-teknikere
Innføringen av elektronisk rapporteringsformat, også kjent som «European Single Electronic Format» (ESEF), har gjort utstederes årsrapporter tilgjengelig på et maskinlesbart format* Årsrapporter skal utarbeides på XHTML-format, mens kravet om merking kun gjelder for konsoliderte finansregnskap avlagt etter IFRS (2018/815 artikkel 3 og 4). Det henger sammen med kravene i rapporteringsdirektivet og IFRS-forordningen, hvor IFRS kreves for konsoliderte finansregnskap, mens nasjonal lovgivning gjelder for selskapsregnskap (2004/109 artikkel 4, pkt. 3) (1606/2002 artikkel 4) (ESMA, 2015)., standardisert på tvers av store deler av Europa. I artikkelen vil ESEF settes inn i en historisk og teknisk kontekst, hvor målet er å synliggjøre den potensielle nytteverdien, samt enkelte ulemper og potensielle forbedringsområder.
Innledningsvis beskrives innføringenav ESEF, samt XBRL-teknologien og utviklingen av denne. Deretter hvordan en regnskapsbruker kan dra nytte av den maskinlesbare dataen, eksemplifisert gjennom enkle funksjoner i programmeringsspråket Python. Dette gjøres for å synliggjøre hvordan ESEF kan åpne for automatisert innhenting og bearbeiding av større mengder data. Avslutningsvis vil det reflekteres rundt fordeler og ulemper med den nåværende løsningen, samt muligheter for videre utvikling. For å begrense artikkelens omfang vil revisors arbeid med ESEF-filen* Accountancy Europe ga i 2019 ut rapporten «Independent Assurance on the European Single Electronic Format” som beskriver revisors arbeid med ESEF. Rapporten bygger på retningslinjene fra Committee of European Auditing Oversight Bodies (CEAOB). og teknisk validering, herunder «linkbase», ikke behandles i detalj.
1. Innføringen av ESEF
Det europeiske råd fastsatte Lisboa-strategien for blant annet å svare på utfordringer knyttet til globalisering, en aldrende befolkningsmasse og tempoet i den teknologiske utviklingen i perioden 2000–2010. Strategiens målsetning var å gjøre EUs økonomi til «den mest konkurransedyktige og dynamiske kunnskapsbaserte økonomien i verden». For å sette strategien i datidens kontekst var oppnåelse av generell tilgang til internett et viktig element, samt et behov for å styrke befolkningens kompetanse rundt bruk av internett. Tilgang til og kompetanse rundt internett tar nok de fleste for gitt i dag (The European Council, 2000).
Halvveis ut i perioden dekket av Lisboa-strategien ble en revitalisering av strategien ansett nødvendig. Det europeiske råd utfordret i 2007 EU-kommisjonen til å fremlegge en plan for å styrke det interne markedet og Europas konkurranseevne, blant annet gjennom bedre regulering i form av forenklinger og reduksjon av administrative byrder, hvor mulig («better regulation»). EU-kommisjonen svarte med initiativet «a simplified business environment»* Målsetningen med initiativet var å danne en politisk konsensus for veien videre rundt lovgivning, særlig på områder som selskapsrett, regnskap og revisjon., hvor et forslag om en forholdsvis bred innføring av elektronisk rapportering og XBRL var inkludert.
Forslaget var ment å dekke rapportering til både myndigheter og investorer, og kunne dermed fått betydning for både noterte og ikke-noterte foretak, inkludert SME-segmentet. Å unngå skreddersydd rapportering for hvert enkelt formål til ulike myndighetsorganer, ved gjenbruk av data, kunne vært et treffsikkert forenklingstiltak for næringslivet («once-only principle») (The European Council, 2007) (The European Commission, 2007).
Europaparlamentet svarte på initiativet med en resolusjon hvor de uttrykte seg positivt til kommisjonens initiativ, særlig til elektronisk rapportering for børsnoterte foretak. Parlamentet trakk imidlertid også frem at de administrative byrdene, inkludert overlappende myndighetsrapportering, i mange tilfeller var grunnet i medlemslandenes nasjonale behov, og ofte hørte til områder utenfor EUs kompetanse. At det endelige lovforslaget kun ville berøre noterte foretak, var derfor ikke overraskende. Siden EU innenfor finansmarkedsregulering oftere krever maksimumsharmonisering, hvor det i begrenset grad åpnes for fravik i nasjonal lovgivning, var implementering for noterte foretak bedre egnet (European Parliament, 2008).
Mens EU diskuterte elektronisk rapportering med et noe langsiktig perspektiv, tok USA store og raske skritt for å implementere teknologien. US SEC åpnet allerede fra 2005 for elektronisk rapportering i form av XBRL, som et valgfritt supplement til den ordinære rapporteringen i EDGAR* Electronic Data Gathering, Analysis and Retrieval System (EDGAR).-systemet for noterte foretak. Etter en prøveperiode ble rapportering etter XBRL obligatorisk fra 2009, med mål om å sikre effektiv kommunikasjon med investorer gjennom internett. For øvrig ble kravet ikke begrenset til årsrapporten. Både kvartalsrapporter og en del øvrige rapporteringskrav til markedet ble også omfattet i kravet til XBRL-merking (SEC, 2005) (SEC, 2009).
Først i 2013* EØS-komiteen traff beslutning om å innlemme endringsdirektivet i EØS-avtalen juni 2020, og i april 2021 ble direktivet innlemmet i norsk rett gjennom endring av verdipapirhandelloven §5-5 og tilhørende forskrift. vedtok EU krav til elektronisk rapportering gjennom endringsdirektivet 2013/50 til Rapporteringsdirektivet* Rapporteringsdirektivet inneholder minstekrav til hvilke opplysninger utstedere og innehavere av omsettelige verdipapirer som er notert på et regulert marked må gi til markedet, herunder periodisk opplysningsplikt jf. vphl. kap. 5.. Virkningstidspunktet ble satt til 1. januar 2020, men det ble senere åpnet for utsettelse til 2021 grunnet Covid-19* Se endringsdirektivet 2021/337.. Artikkel 4 «Årsrapporter» ble da tilført et generelt utformet krav om at årsrapporten skulle utarbeides på et digitalt rapporteringsformat* Da loven ble vedtatt, var det ikke fastsatt at den elektroniske rapporteringen skulle baseres på XBRL-teknologien. Det lå imidlertid i kortene at en form for XBRL-teknologi trolig ville bli valgt.8. Selv om flere brukere og utstedere ser ut til å legge mest vekt på årsrapportene offentliggjort i et menneskelesbart format som PDF, er det ZIP-/Xbri-filen som nå er den offisielle årsrapporten (ESMA, 2024).
Det kan imidlertid virke som om kommisjonen ikke var helt forberedt på at elektronisk rapportering skulle inkluderes i endringsdirektivet. Endringsdirektivet omhandlet hovedsakelig hyppighet av periodisk rapportering (halvårsrapporter), flaggeregler og land-for-land rapportering, ikke elektronisk rapportering. Som beskrevet av ESMA, var det Europaparlamentet som tok initiativ til å inkludere elektronisk rapportering. Det kom imidlertid forholdsvis sent inn i lovarbeidet, så det var blant annet ikke utarbeidet konsekvensanalyse. ESMA fulgte derfor opp med noen mer generelle spørsmål i den etterfølgende høringsprosessen tilbake i 2015, for å innhente synspunkt også på selve lovvedtaket (ESMA, 2015).
Tilbakemeldingene på de generelle spørsmålene var som forventet delte. Enkelte så tiltaket som en kostnadsøkning for utsteder uten nytte for regnskapsbruker, en ressurskrevende «compliance»-øvelse. En rekke franske organisasjoner var særlig negative og la vekt på enkelte ulemper knyttet til den foreslåtte løsningen, hvorav noen vil gjennomgås senere i denne artikkelen. På et generelt grunnlag virket imidlertid tiltaket å være godt mottatt, og et egnet tiltak for å etablere standardisert elektronisk rapportering på tvers av landegrenser i EU, i tråd med målsetningen om et integrert finansielt marked. Gjennom ESEF fikk alle med tilgang til datamaskin og internett mulighet til å utnytte elektronisk rapportering, en mulighet som først og fremst hadde vært tilgjengelig for ressurssterke brukere, inkludert institusjonelle investorer og trolig tilsynsmyndigheter, med tilstrekkelige ressurser til å kjøpe og utnytte elektronisk data fra databehandlere («data aggregators») (ESMA, 2016).
Derfor er det rimelig å forvente at et eventuelt informasjonsgap mellom retail-investorer og de institusjonelle investorene ville reduseres av innføringen av obligatorisk elektronisk rapportering. Å måle informasjonsgap og endring av denne er imidlertid en krevende øvelse det er knyttet stor usikkerhet til. En interessant undersøkelse har imidlertid vist at informasjonsgapet potensielt kan øke mellom de investorgruppene som er i stand til å nyttiggjøre den elektroniske rapporteringen, og de som ikke er det. Som konsekvens kan investorer med tilstrekkelige ressurser og kompetanse få bedre data, samtidig som de slipper kostnaden ved bruk av databehandlere («disintermediation»), mens øvrige investorer vil måtte fortsette som før (Gomez, 2020).
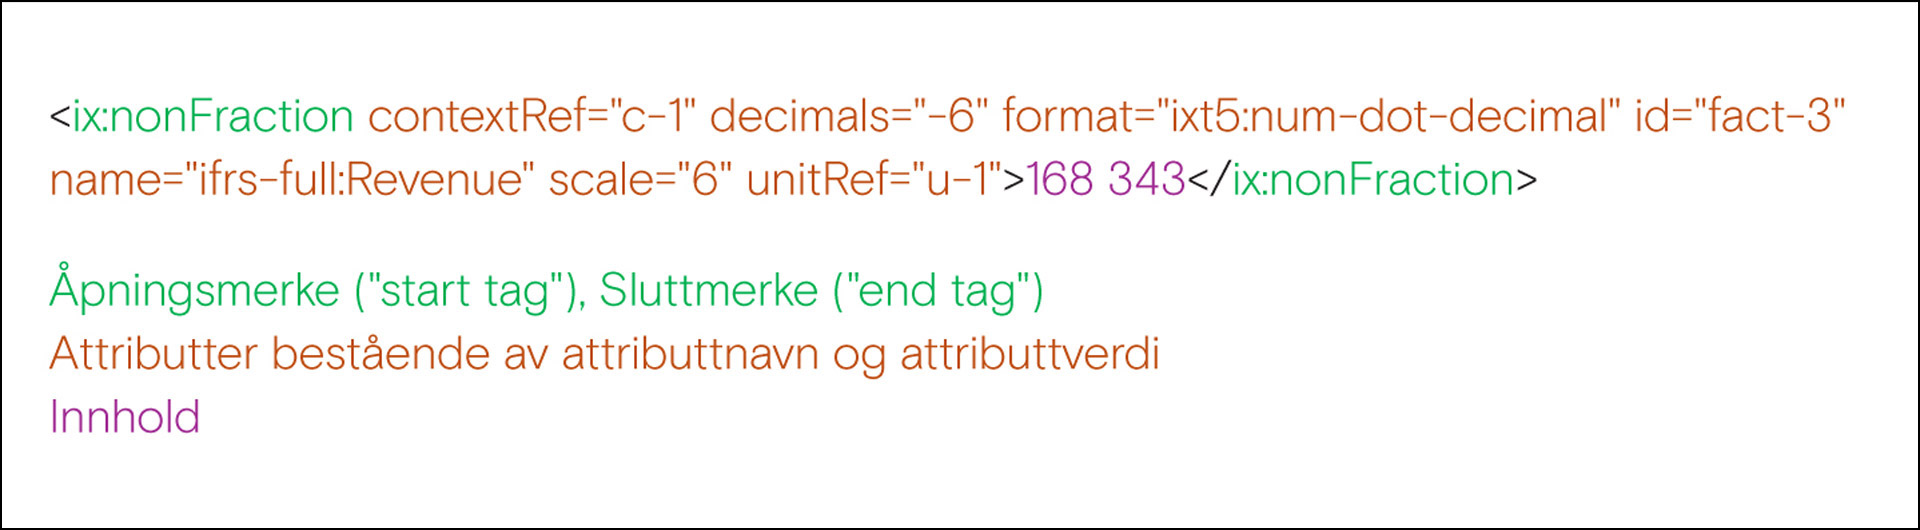
Illustrasjonen viser et eksempel på et XBRL-element
2. Utviklingen av XBRL – Fra ustrukturert til strukturert format
2.1 Opprinnelsen av XBRL og XML
For å forstå XBRL i noe mer detalj er det nødvendig å trekke de lengre linjene og knytte det opp mot øvrig teknologiutvikling. Det var tilbake på 70-tallet at SGML* Standard Generalised Markup Language (SGML) ble etablert som ISO 8879 først i 1986. ble utviklet, en standard som definerte overordnede krav og spesifikasjoner for merkespråk til bruk i en tekstfil* Med tekstfil menes her «plain text»-filer hvor standarder som Unicode UTF-8 og ASCII brukes for å representere tegn ut ifra datamaskinens binære datapunkt («character encoding»). Selv om XHTML er et tekstfilformat, åpner Base64 for å inkorporere bilder direkte i XHTML-filen, noe som benyttes i utstrakt grad i ESEF-rapporter (Baker, 2021).. Merking åpnet for å knytte metadata til data i et elektronisk format, ved bruk av blant annet merker og attributter. Som et eksempel kan et tall (data) merkes som inntekter for et spesifikt år (metadata). Å bruke tekstfiler til å lagre data på en strukturert måte var god utnyttelse av datamaskinens begrensede ressurser i en tid da lagring og overføringskapasitet var vesentlig mer kostbart enn det vi er vant med i dag. Fortsatt den dag i dag er tekstfiler en sentral del av den digitale verden.
For å sette SGML inn i en kontekst er det hensiktsmessig også å nevne HTML i korte trekk. Filformatet HTML er godt egnet til overføring og gjengivelse («rendering») av nettsider, og en sentral byggesten i utviklingen av internett. Mens SGML setter de overordnede rammene for merkespråk, er HTML-standarden en anvendelse av SGML, som blant annet beskriver merker og attributter som er mulige å bruke, og hvilken funksjon de skal ha.
Målet med standardisering er ofte å gjøre praksis mer ensartet. Ved å etablere en HTML-standard skulle alle nettlesere kunne lese en HTML-fil og gjengi nettsiden på samme måte («interoperabilitet»). Bruken av HTML utviklet seg imidlertid ikke helt heldig ved utbredelsen av internett på 90-tallet. Standarden ble ikke alltid etterlevd, og det ble utviklet proprietære løsninger for de enkelte nettleserne fremfor å følge en universell standard* Dette ble til dels også gjort bevisst. Som en konsekvens av konkurransen mellom nettlesere («browser wars»), ble merkene ikke alltid tolket på samme måte, og nettlesere hadde også egne merker og varianter av eksisterende merker. De gjeldende standardene ble også snilt tolket av nettlesere, slik at også HTML-filer med feil og mangler ble forsøkt gjengitt av nettlesere.. Mangelen på ensartet praksis bidro trolig til at HTML ikke var like aktuell for lagring og overføring av data. Den oppdaterte HTML-standarden er bedre etterlevd i dag, men det er fortsatt en fleksibel og mindre streng standard, og nettlesere vil aktivt forsøke å rette opp og gjengi feilaktig kode i HTML (Ferrara, 2025) (Anderson, 2004).
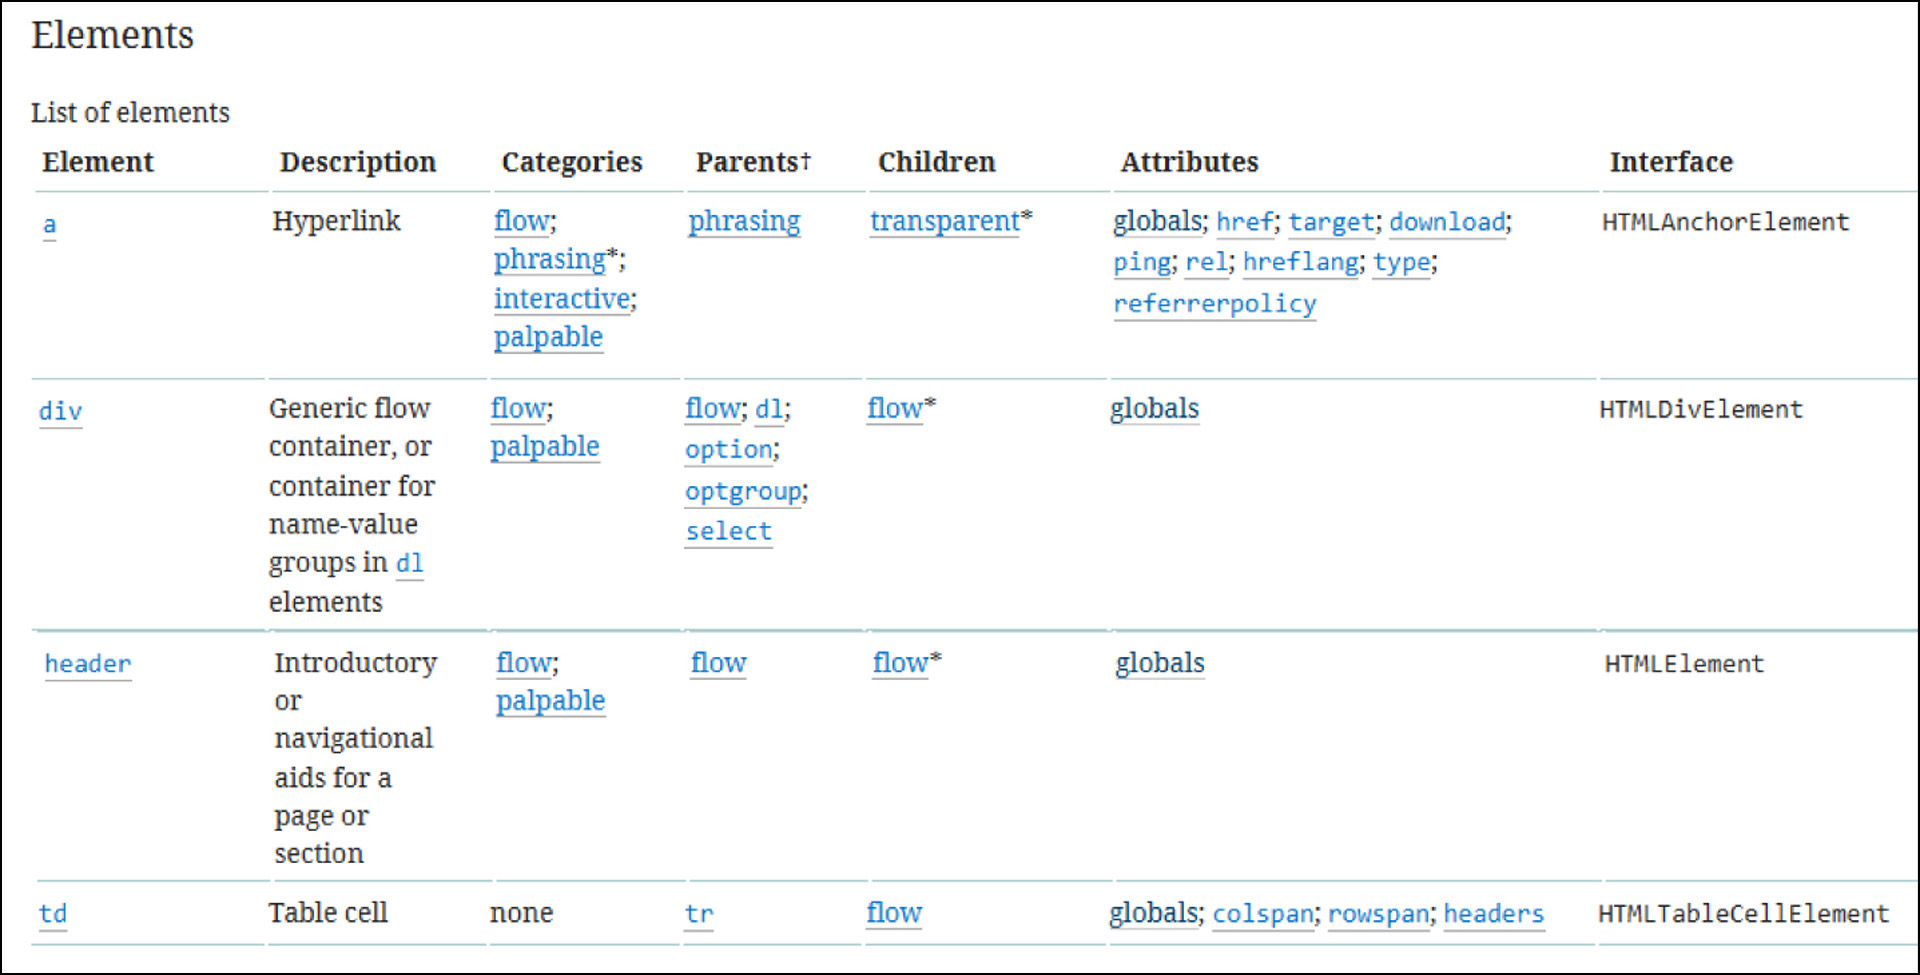
Illustrasjonen viser et mindre utvalg av merker definert av «HTML: Living Standard». Blant annet beskrives funksjon og tillatte attributter for hve type av merke.
Siden SGML er en forholdsvis generell standard, som blant annet inneholder flere valgalternativer, ble det ansett nødvendig med et strengere alternativ. Særlig for lagring og overføring av data er det mindre hensiktsmessig med fleksibilitet og valgalternativer fordi IT-applikasjoner da ikke nødvendigvis håndterer data på samme måte. Som en underkategori av SGML ble «Extensible Markup Language» (XML) utviklet, med færre valgalternativer og strengere struktur- og innholdskrav. Etter hvert er det blitt enda flere merkespråk, som kan organiseres i en form for familietre, hvor SGML er «mor» og XML en underkategori (Ferrara, 2025)* Extensible Markup Language (XML) 1.0 vedlikeholdes av World Wide Web Consortium, forkortet W3C..
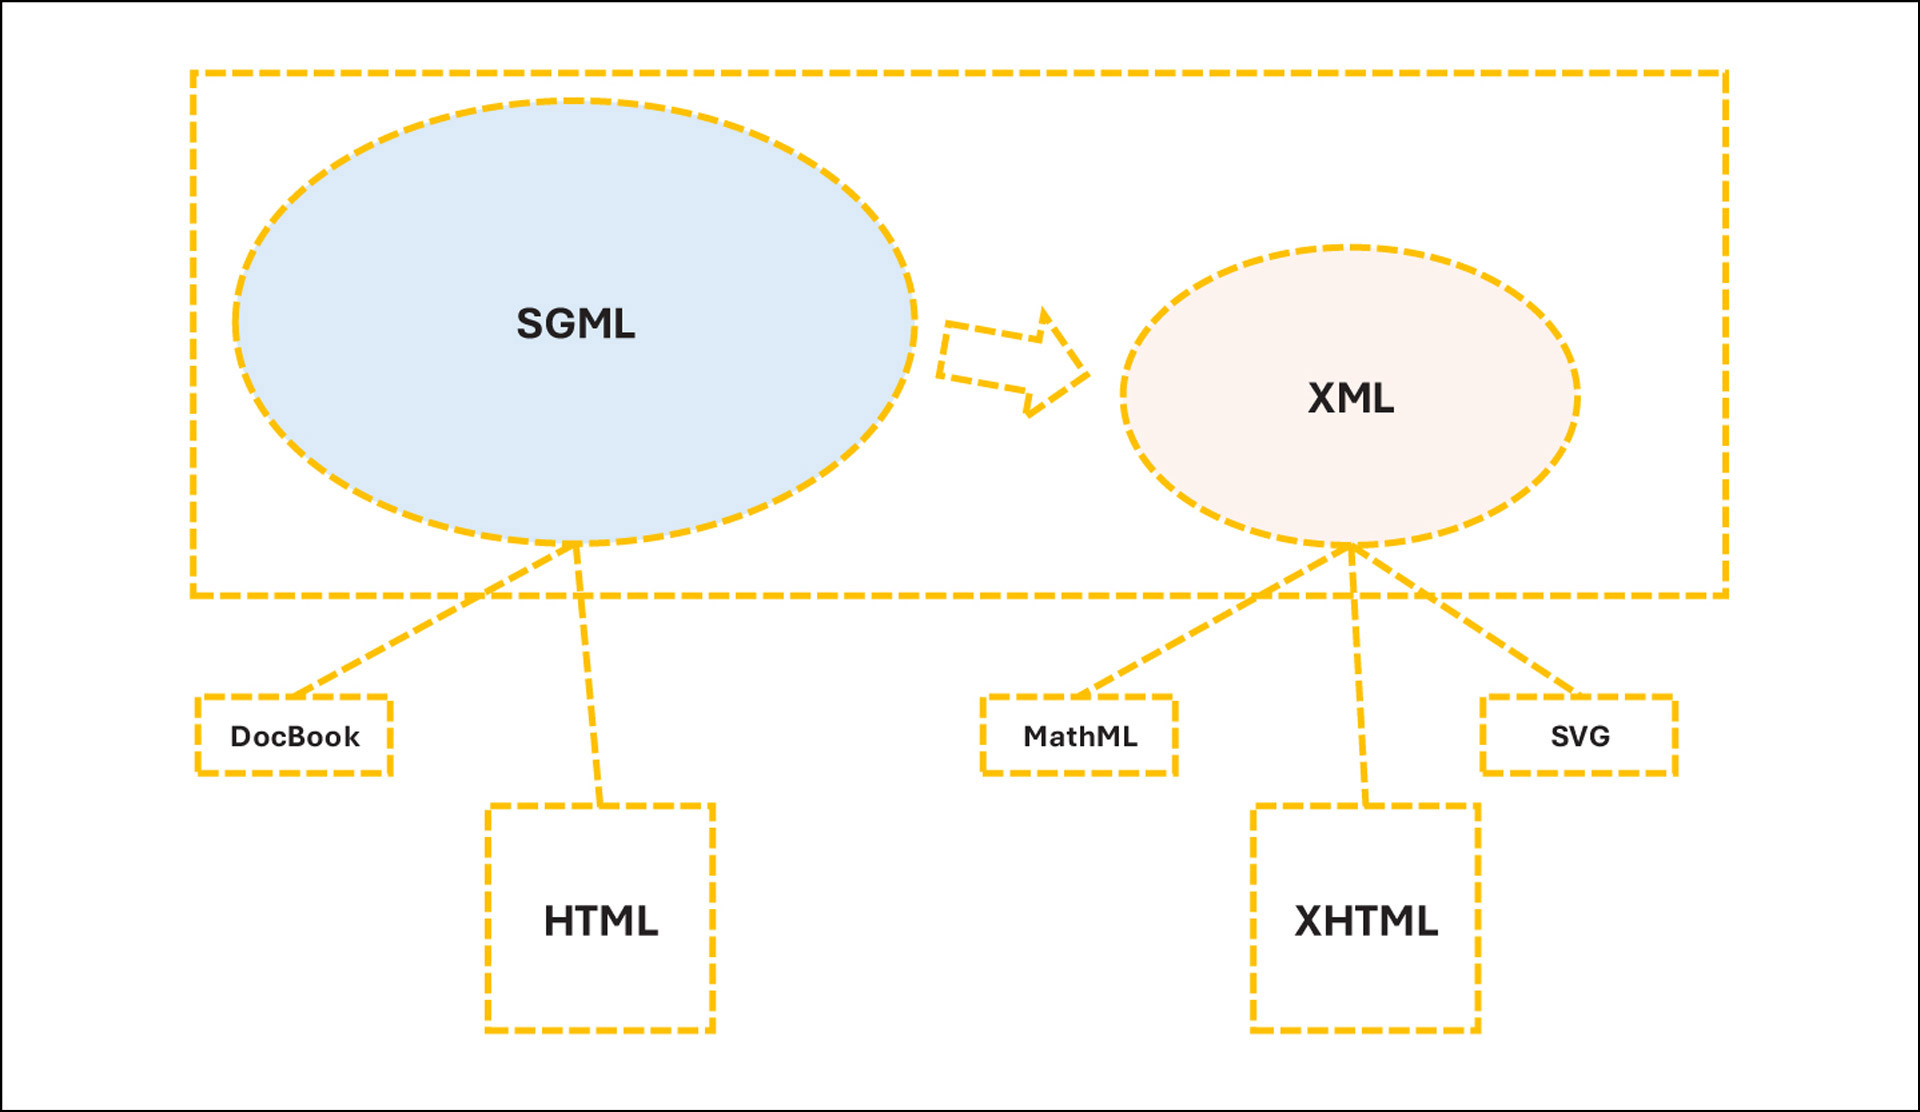
Illustrasjonen viser forholdet mellom enkelte meta- og markeringsspråk.
Tilsvarende SGML, og i motsetning til HTML, definerer ikke XML hvilke elementer eller attributter som kan brukes for å merke data, men setter de overordnede rammene gjennom noe strengere regler enn SGML. For å anvende XML til et spesifikt formål må formålet dermed begrense hvilke merker og attributter som kan brukes. Det kan gjøres gjennom utarbeidelse av et XML-skjema* «XML Schema Definition» (.xsd)., hvor tillatte merker og attributter er definert (W3C, 2004).
Mot slutten av 1990-tallet, i kjølvannet av utviklingen av XML, ble det tatt initiativ til utvikling av en global standard for elektronisk rapportering. Initiativet kom opprinnelig fra miljøet rundt American Institute of Certified Public Accountants (AICPA)* Revisoren Charles Hoffman nevnes som grunnleggeren av XBRL, men utviklingen ble innen kort tid del av et større miljø., men ble etter kort tid trukket ut gjennom etableringen av den globale organisasjonen XBRL International i 1999. Dette som følge av at ambisjonen om å utvikle en global standard, ikke passet inn i AICPA med USA som et mer lokalt nedslagsfelt (Waldt, 2004)* I 2009 ble XBRL Europe etablert som en selvstendig organisasjon med fokus på prosjekter i Europa..
Organisasjonen utviklet grunnlaget for dagens XBRL 2.1-spesifikasjon. Gjennom spesifikasjonen defineres hvilke merker og attributter som kan brukes som metadata, og hvilken funksjon de skal ha. Spesifikasjonen er implementert i et XML-skjema som er inkludert i appendiks til XBRL 2.1. For at noen skal kunne legge ned påstand om et dokuments etterlevelse av XBRL, eksempelvis finansregnskapet i en årsrapport, må dokumentet dermed både etterleve XBRL 2.1-spesifikasjonene og XML 1.0* Et dokument som etterlever XML 1.0 sies å være «well-formed», mens ved etterlevelse av det spesifiserte skjemaet er dokumentet også «valid».. Standarden sikrer på denne måten et konsistent format for utarbeidelse og utveksling av finansiell data, som gjør at data effektivt kan utveksles direkte mellom IT-applikasjoner, inkludert til investorer og myndighetsorgan (XBRL International, 2013).
2.2 Fra XML og XBRL til HTML/XHTML og Inline XBRL
EU vurderte XBRL basert på XML som ett av flere alternativ i kost-nytte-analysen tatt inn i høringsdokumentet* Lovgiver påla ESMA å utføre en kost-nytte-vurdering blant annet for å kompensere for at konsekvensanalyse ikke ble gjennomført i forkant av lovvedtaket (ESMA, 2015).. Siden XML først og fremst er tilpasset maskinell behandling, blir da XML-filen et supplement til det menneskelesbare filformatet. Hvis brukerne da skulle bli usikre på om de to separate filene var identiske eller ikke, ville de fort valgt den filen de hadde mest tillit til, noe som hadde gjort den andre filen overflødig (ESMA, 2015).
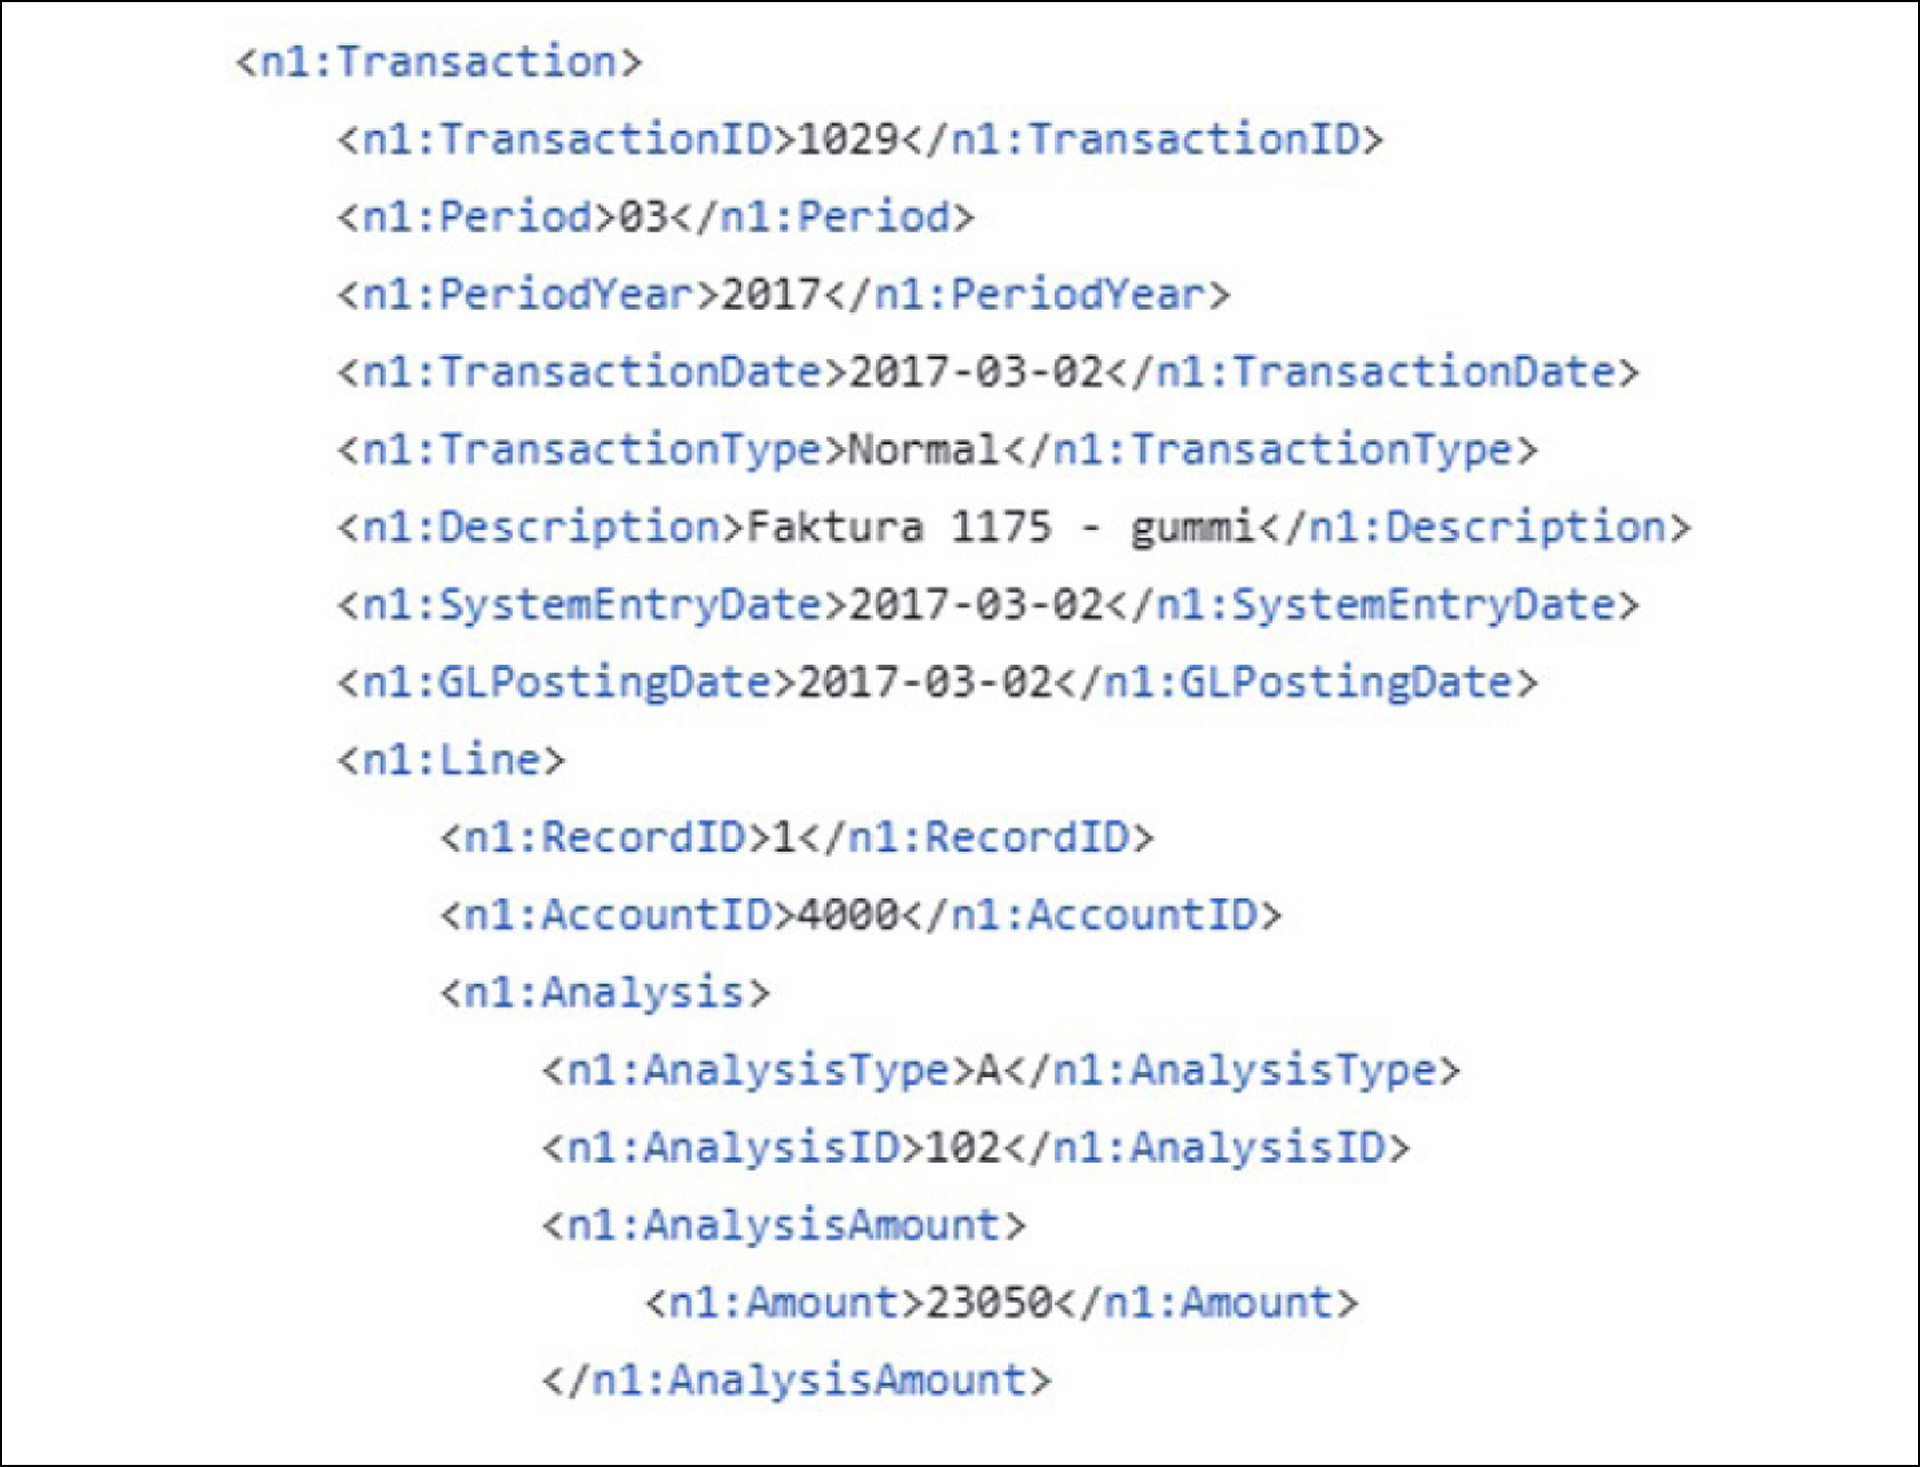
Illustrasjonen viser et eksempel på en SAF-T-fil hvor relasjoner mellom data etableres gjennom «nøsting».
Da US SEC innførte elektronisk rapportering, var det i første omgang XBRL basert på XML, og dermed to separate filer. Enkelte undersøkelser viste at brukerne ikke alltid hadde full tillit til den maskinlesbare rapporten, og at de derfor la mer vekt på den menneskelesbare rapporten. Det dukket også opp påstander om at utstederne bevisst rapporterte XBRL-filer av lav kvalitet, med formål å undergrave US SECs mandat om innføring av elektronisk rapportering, blant annet gjennom unødig bruk av selskapsspesifikke merker («extensions»). Uten brukernes tillit blir den maskinlesbare rapporten overflødig, så rapporteringskvalitet i alle steg er avgjørende (Harris & Morsfield, 2012).
Siden løsningen med to separate filer hadde enkelte ulemper, ble en undergruppe av XBRL utviklet, som ble navngitt Inline XBRL. I Inline XBRL inkorporeres den maskinlesbare XBRL-dataen i et format som er bedre egnet for menneskelig lesbarhet, hvor filformat som HTML eller XHTML brukes i stedet for XML. I stedet for to filer er det altså kun én fil som inneholder både den maskinlesbare og den menneskelesbare rapporten. Som beskrevet i Inline XBRL 1.1-spesifikasjonen, må den maskinlesbare XBRL-rapporten kunne trekkes ut av filen på en slik måte at den etterlever kravene i XBRL 2.1. Som vil vises senere i artikkelen, er metadata inkludert i den samme filen som også gir en menneskelesbar rapport, men «gjemt» på en slik måte at det ikke påvirker hvordan en nettleser vil gjengi den menneskelesbare rapporten* Nettlesere gjengir ikke XBRL-metadata som ligger som XBRL-elementer. Det er kun selve innholdet som blir gjengitt av nettleserne, og dermed synlig i den menneskelesbare rapporten. (XBRL International, 2013).
En av fordelene ved XML er at det åpner for en nøstet struktur («nesting»). Ved å plassere elementer inni hverandre etableres en hierarkisk struktur som skaper relasjoner mellom data. Eksempelvis gjøres dette i SAF-T-rapporter, ved at data tilhørende den enkelte bokføring «nøstes» sammen med bokføringsnummeret, inkludert beløp, konto og bokføringsdato. Denne løsningen er ikke like hensiktsmessig når data skal kunne gjengis som en menneskelesbar rapport av en nettleser. Derfor er konseptet «linkbase», som er en annen tilnærming for å etablere disse relasjonene, særlig viktig for Inline XBRL. Det gjør det mulig å gjenskape årsrapporten i riktig format, også maskinelt, samtidig som man bevarer utstedernes fleksibilitet rundt utformingen av årsrapporten.
2.2.1 Hvorfor XHTML?
De fleste kjenner godt til HTML som et format til bruk i nettlesere for gjengivelse av nettsider. Som beskrevet ovenfor, er HTML en forholdsvis fleksibel standard, og nettlesere vil forsøke å gjengi nettsider selv om den underliggende HTML-filen inneholder feil. Siden dette gir noe risiko for at HTML-filer ikke tolkes konsistent på tvers av IT-systemer, er det ikke et godt egnet format for datalagring og -overføring. Da er de strengere reglene i XML bedre egnet.
XML er imidlertid ikke et godt egnet grunnlag for en menneskelesbar rapport. Derfor legger Inline XBRL opp til bruk av filformatet XHTML, som i tillegg til å etterleve HTML-standarden også etterlever de strengere kravene i XML-standarden. XHTML kan derfor leses av en nettleser og gjengi en menneskelesbar rapport, på samme måte som en nettside kan gjengis basert på en HTML-fil. Sammenlignet med ordinære HTML-filer vil derimot en nettleser ikke forsøke å rette opp og gjengi feilaktig kode i XHTML. Nettleseren vil heller stoppe umiddelbart og gi en feilmelding hvis dokumentet inneholder syntaksfeil (XBRL International, 2013).
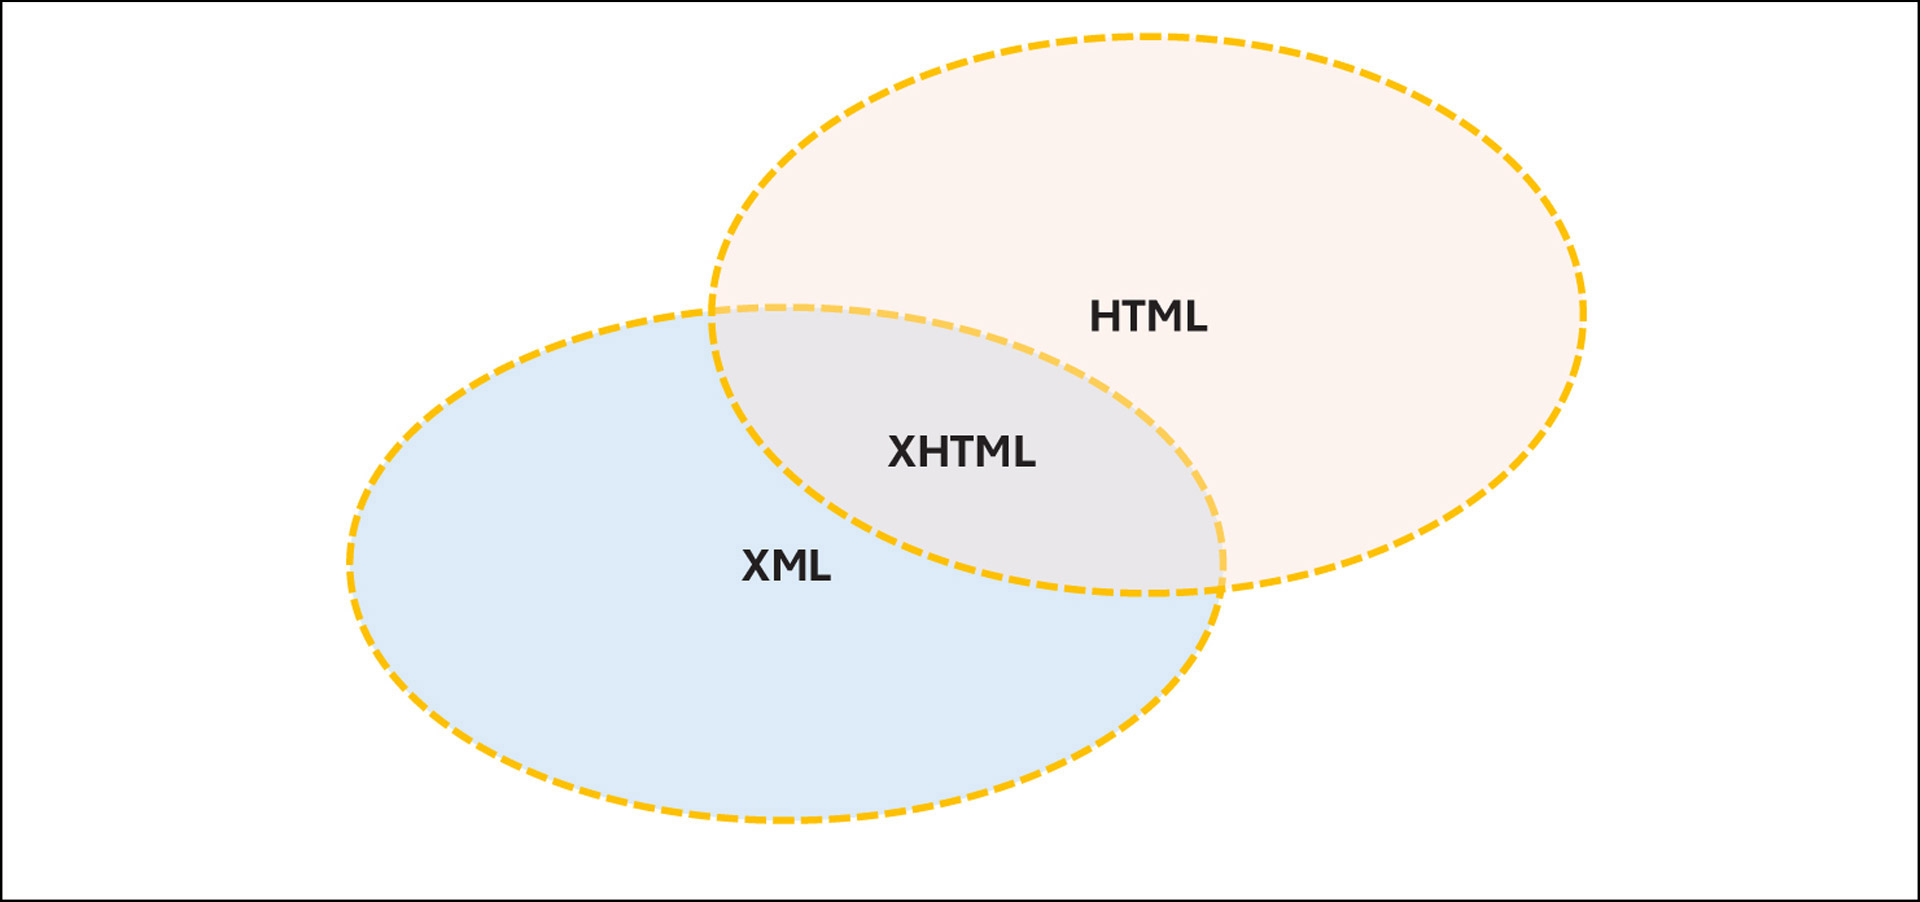
Filformatet XHTML etterlever både HTML-standarden og de strengere kravene i XML-standarden.
2.2.2 Hvorfor filene ofte krever mye lagringsplass – Illustrasjoner i tekstfiler (Base64)
Merking av data i en tekstfil skal i utgangspunktet være effektiv bruk av en datamaskins ressurser. Likevel ser man ofte at ZIP-filene som rapporteres under ESEF, er av vesentlig størrelse. Årsakene til dette er flere, men bruken av illustrasjoner i årsrapporter er en vesentlig bidragsyter (Warren, 2022).
I motsetning til «filings» hos US SEC, hvor strenge format- og stilregler må etterleves, er det i Europa tradisjon for særegne format på årsrapportene, gjerne med utstrakt bruk av bilder, farger og tekststiler. Selv om Inline XBRL-filene er tekstfiler, er det mulig å inkorporere slike illustrasjoner i selve XHTML-filen, eksempelvis gjennom bruk av Base64-teknologien.
XBRL anbefaler nå at slike filer legges i samme mappe som XHTML-filen, men at de ikke inkorporeres direkte i filen. ESEF-manualen legger derimot opp til at illustrasjoner inkorporeres direkte i XHTML-filen, så lenge filstørrelsen ikke overstiger nettlesernes kapasitet, heller enn at det legges i separate filer utenfor XHTML-filen (ESMA, 2025) (XBRL International, 2024).
2.3 Taksonomi
De tekniske spesifikasjonene XBRL 2.1 kan noe forenklet sagt anses som et rammeverk som må fylles med innhold* I artikkelen er «facts» slik det er definert i XBRL, oversatt til «innhold».. XBRL gir de grunnleggende byggestenene som skal være felles for alle rapporter basert på XBRL, inkludert strukturer, merker, attributter og datatyper. XBRL er imidlertid ikke tilstrekkelig til å kommunisere finansiell rapportering i seg selv. For å få i stand en rapport må også attributtverdier fra regnskapsspråket inkluderes, samt den finansielle dataen fra selskapet (XBRL International, 2026).
Taksonomien reflekterer en definert regnskapsstandard og bygger videre på XBRL-rammeverket for klassifisering av innholdet. En programvare som skal lese en XBRL-rapport, vil kunne finne og håndtere data basert på XBRL-spesifikasjonen, men det er taksonomien som definerer hvilken regnskapslinje eller -note som tallet eller teksten hører til.
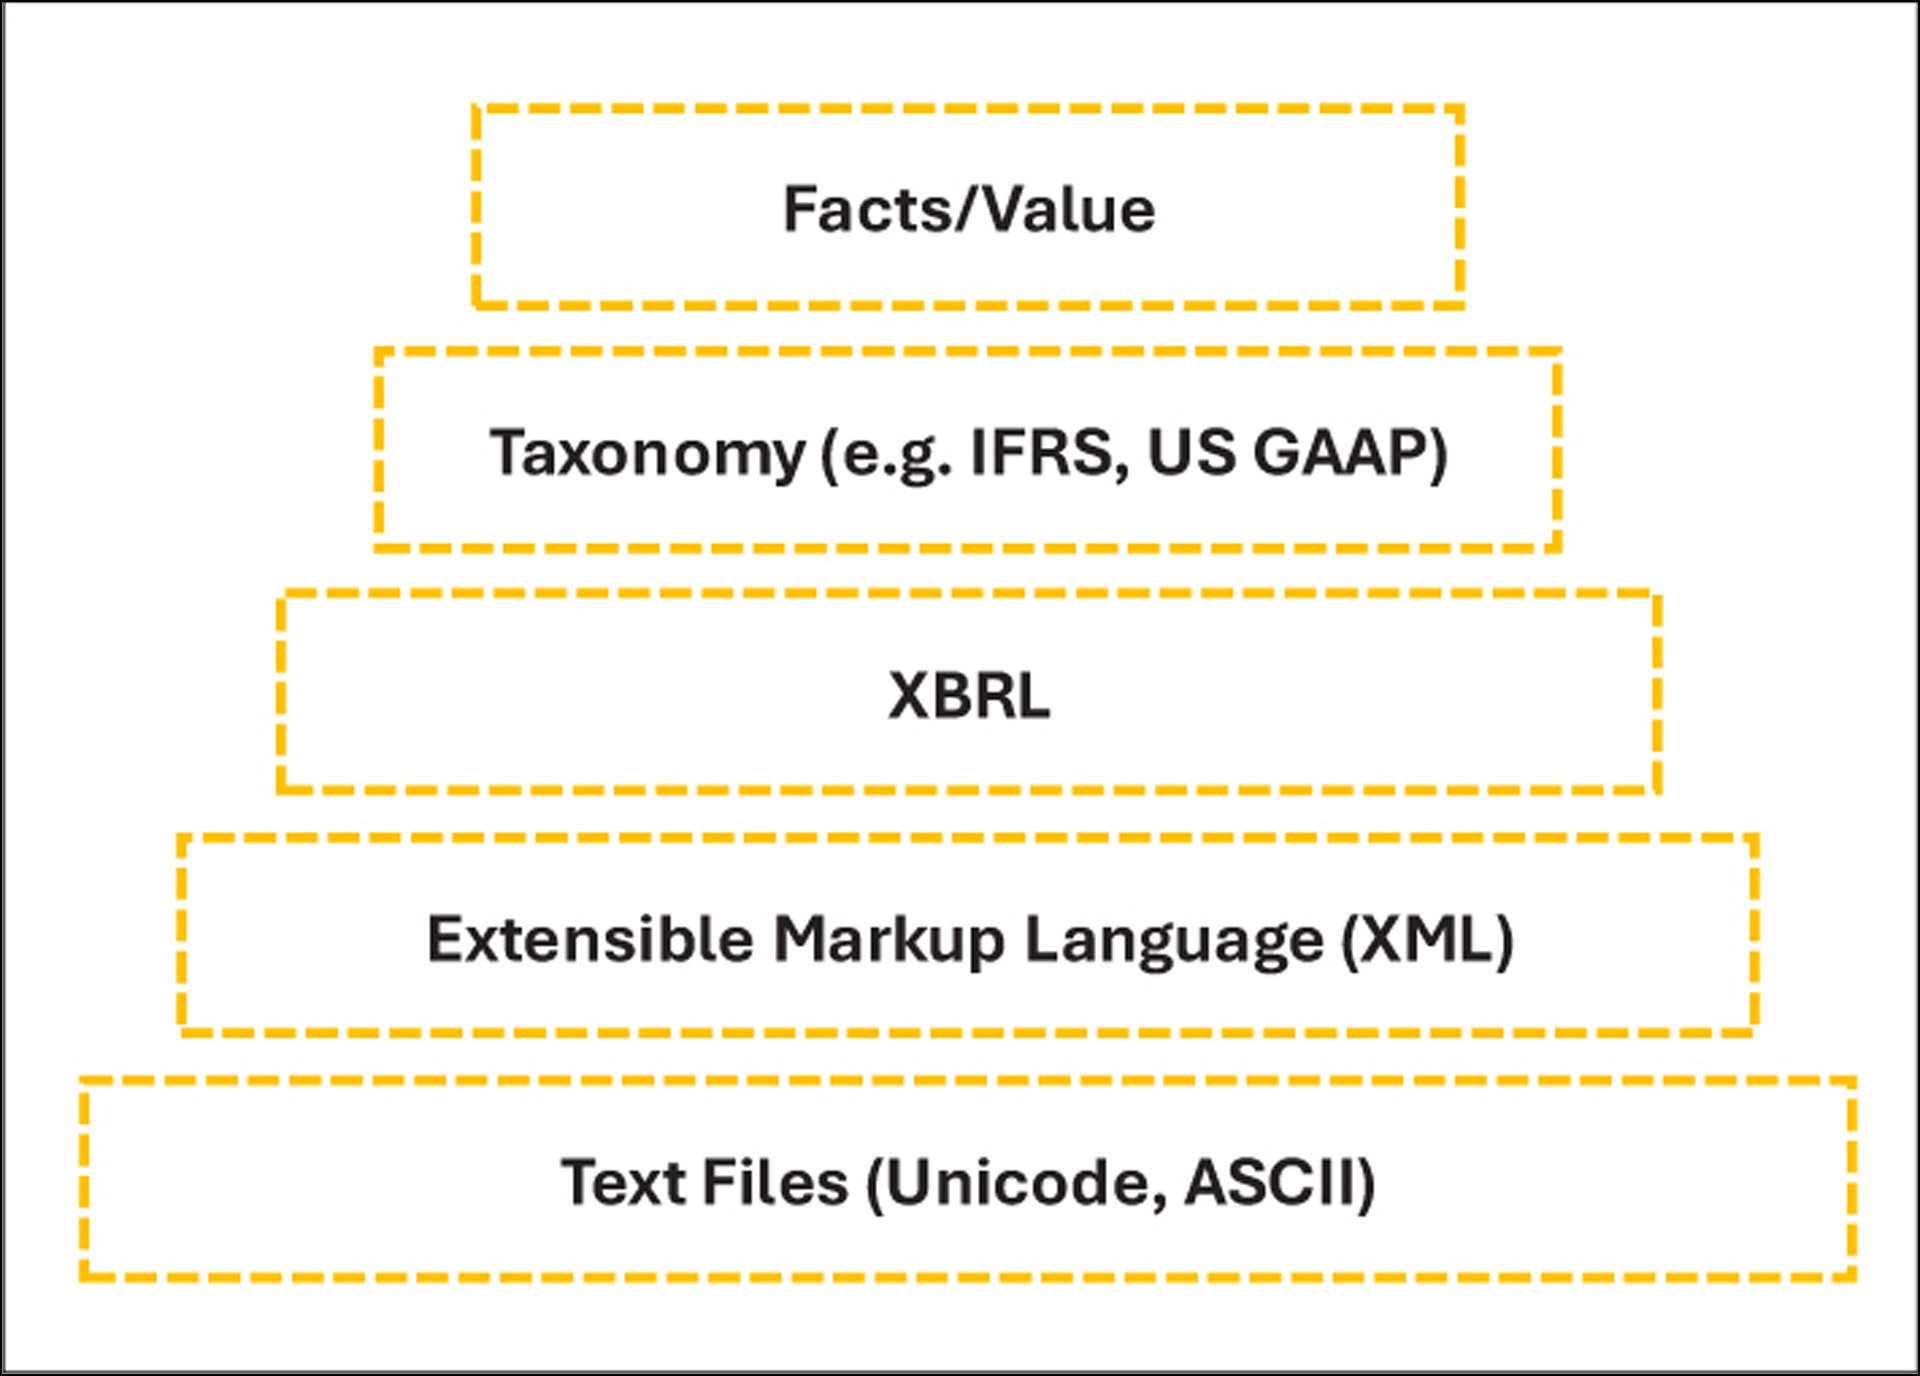
Flere standarder ligger til grunn for en rapporteringsfil.
Tilsvarende som for XBRL, er også taksonomier definert i et skjema som definerer hvilke merker og attributter som kan benyttes. XBRL åpner imidlertid for bruk av selskapsspesifikke merker («extensions»), for å ta høyde for tilfeller som faller utenfor de områdene som er definert av taksonomien (XBRL International, 2026).
I høringsprosessen til de tekniske standardene ble det diskutert hvorvidt ESEF skulle åpne for selskapsspesifikke merker. Erfaringene fra US SEC, hvor unødig bruk av selskapsspesifikke merkinger reduserte sammenlignbarheten mellom selskap, trakk i retning mot ikke å åpne for dette. Man falt imidlertid ned på at fleksibiliteten innebygd i IFRS tilsa at det burde være tillatt. Tiltak ble etablert for å forebygge de potensielle ulempene, herunder «ankring» til nærmeste IFRS-merking, samt krav om tredjeparts bekreftelse av revisor (Harris & Morsfield, 2012) (ESMA, 2025).
ESMA oppdaterer taksonomien på årlig basis ved å oppdatere den delegerte kommisjonsforordning (EU) 2018/815. EU-kommisjonen vedtar denne gjennom delegert myndighet (RTS). ESEF-taksonomien er i stor grad basert på IFRS-taksonomien utgitt av IASB, som har eksistert i lengre tid. IASB utarbeidet det første utkastet allerede i 2002, og det ble etter hvert videreutviklet som et delprosjekt under paraplyprosjektet «disclosure initiative» (Ramin & Prather, 2003).
2.3.1 Eksempel på merking
Et eksempel kan være nyttig for bedre å forstå hvilke roller XBRL-teknologien og taksonomien har ved merking av finansiell informasjon. I stedet for å åpne XHTML-filen i en nettleser, som gir en menneskelesbar rapport, kan filen åpnes som ren tekst i et enkelt tekstredigeringsprogram, eksempelvis gjennom Microsoft Notisblokk. Da ser man hvordan filen er oppbygd, og dermed hvordan XBRL åpner for effektive søk på enkeltelementer i finansregnskapet.
I illustrasjonen ovenfor er XBRL-element fra to rapporter hentet ut. Selv om eksemplene er fra forskjellige jurisdiksjoner og regnskapsspråk, er strukturen stort sett lik. Den viktigste forskjellen ligger i «name»-attributtet. Hvilken verdi denne attributten kan ha, defineres av taksonomien fra regnskapet.
Som nevnt ovenfor, vil en nettleser ikke gjengi alle merkene og attributtene i en Inline XBRL-fil. Det er kun innholdet som vil fremkomme i den menneskelesbare rapporten. XHTML-filen vil også bestå av øvrige merker og attributter fra HTML og CSS, som blant annet definerer hvor innholdet skal plasseres og hvordan det skal se ut i den menneskelesbare rapporten, men som ikke faller under XBRL-standarden.
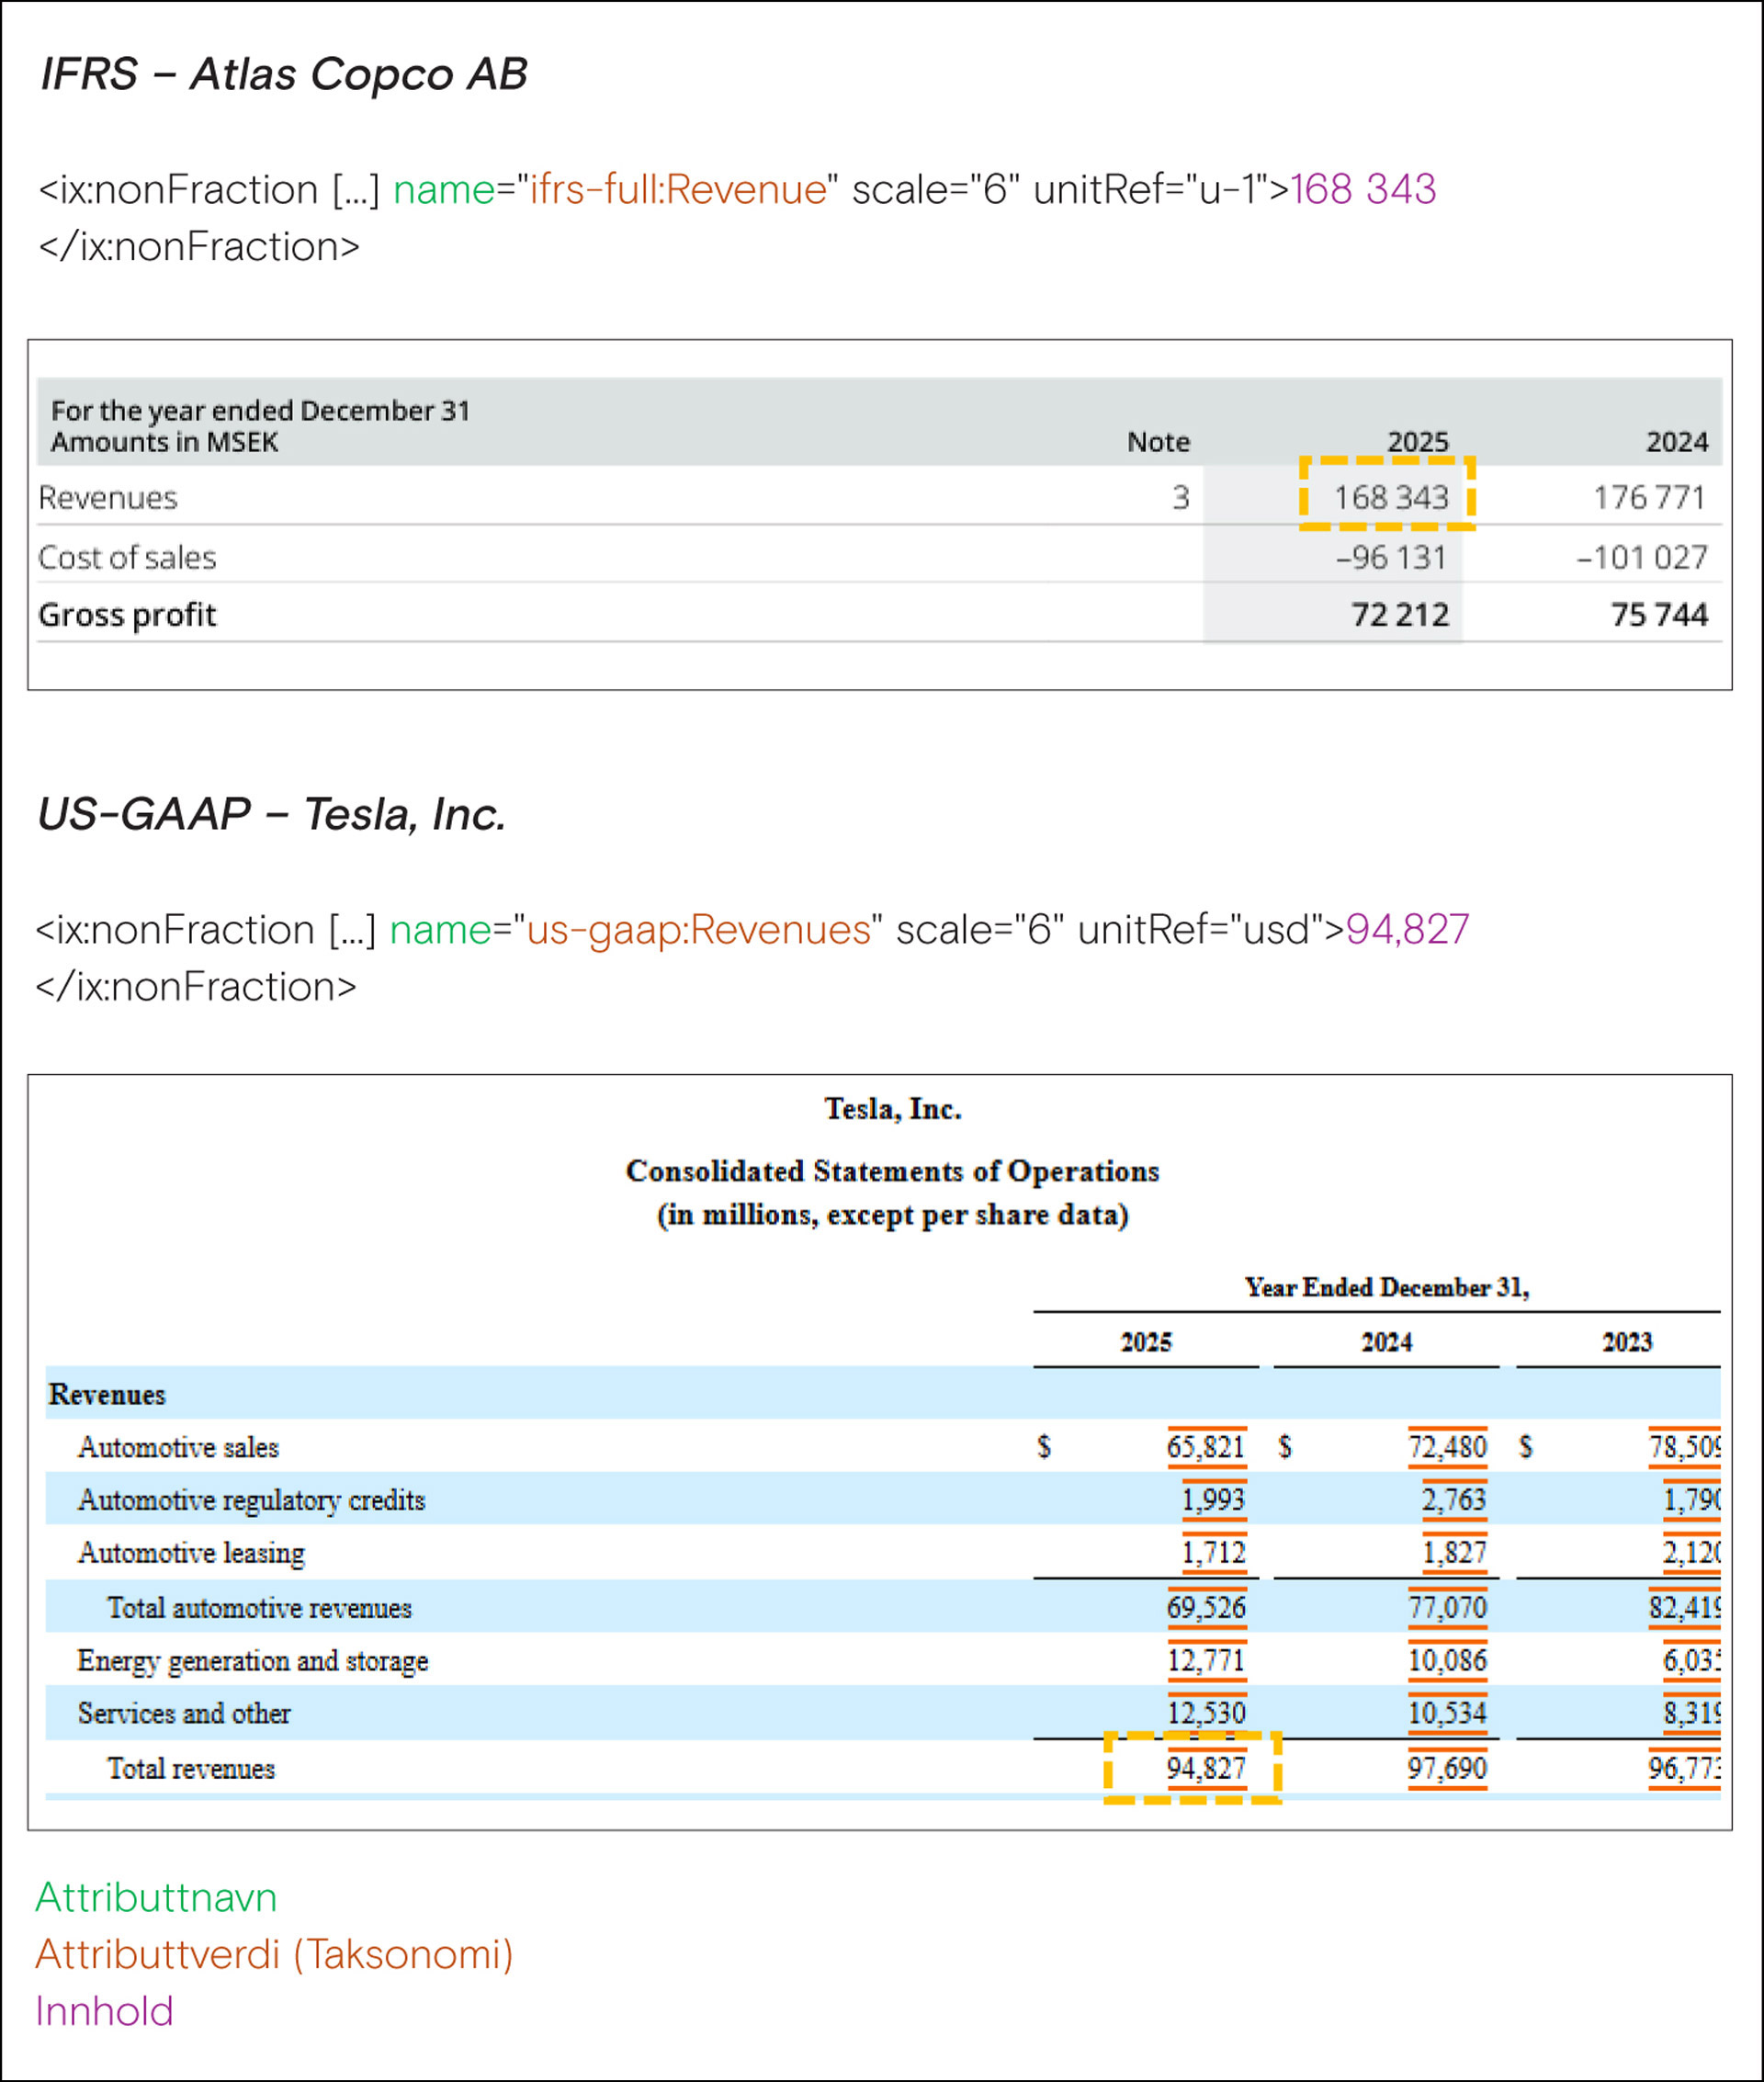
Verdien angitt for attributten «name» avhenger av regnskapsspråk og tilhørende taksonomi. I illustrasjonen er IFRS og US GAAP benyttet som regnskapsspråk, med attributtverdiene «ifrs-full:Revenue» og «us-gaap:Revenues».
2. Eksempel på maskinlesning* For å unngå å gjøre eksempelet for komplisert fokuseres det kun på selve XHTML-filen, og ikke utnyttelsen av Discoverable Taxonomy Set (DTS) inkludert linkbase.
Å gi et eksempel på hvordan den maskinlesbare dataen kan nyttiggjøres, er en god måte å belyse fordeler og ulemper med nåværende løsning på. Det finnes imidlertid ulike tilnærminger og programvarer for den maskinlesbare dataen, som må tilpasses brukens formål.
XBRL Europe fører en liste over programvare for både utarbeidelse og konsumering av XBRL-filer* ESEF Hub: Tools.. Flere brukere, særlig tilsynsmyndigheter og institusjonelle investorer, har trolig tilgang til denne type programvare, som kan utarbeide gode standardiserte analyser med et generelt formål. Brukere som heller ønsker å utarbeide skreddersydde analyser til spesifikke formål, vil kunne ønske mer fleksibilitet i programvaren. Da kan de mer generelle programmeringsspråkene, eksempelvis Python, Java og R, være et bedre egnet alternativ. Disse er ofte gratis, og dermed tilgjengelige også for investorer med begrensede ressurser, med tilgang til en rekke ferdigprogrammerte pakker som er åpent tilgjengelig for bruk fra «åpent kilde»-samfunnet («open source») som enkelt kan tilpasses behovet.
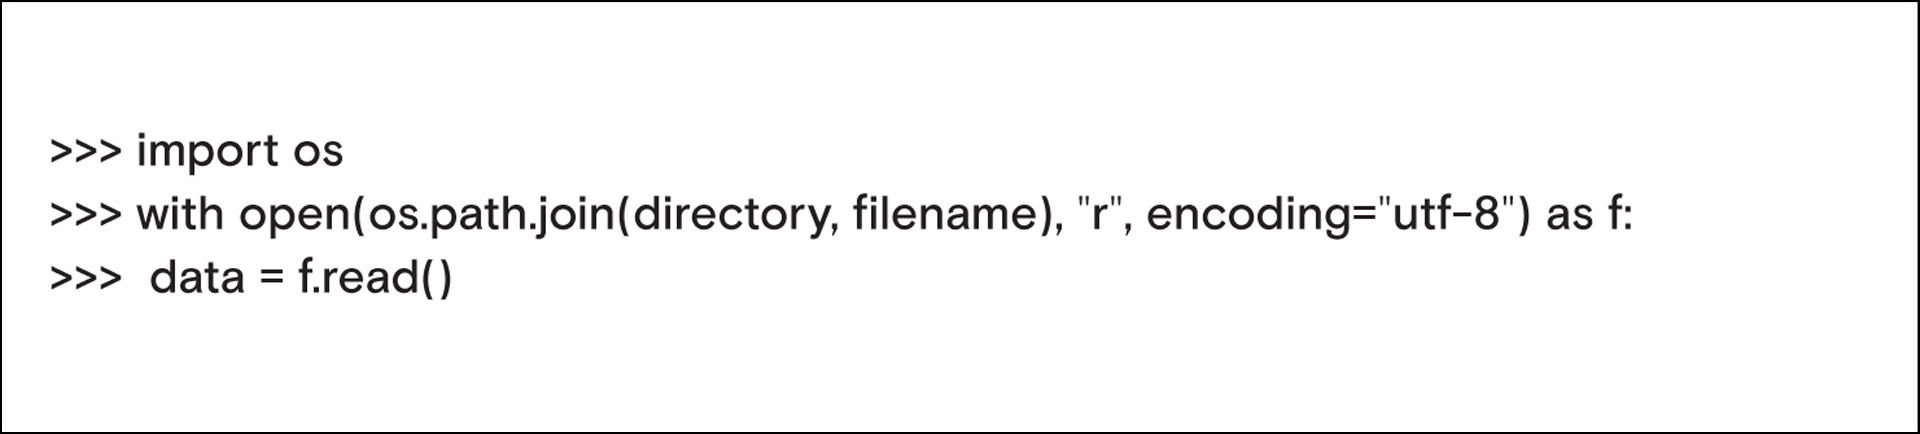
Tekstfilen lastes fra permanent lagring i harddisken til det midlertidige minnet. Variabelen «data» refererer til den innlastede filen.
I denne artikkelen vil programmeringsspråket Python benyttes for å eksemplifisere bruk av maskinlesbar data, gjennom noen helt enkle kommandoer. Selv om kommandoene er enkle, vil det bidra til å synliggjøre hvilke muligheter som finnes.
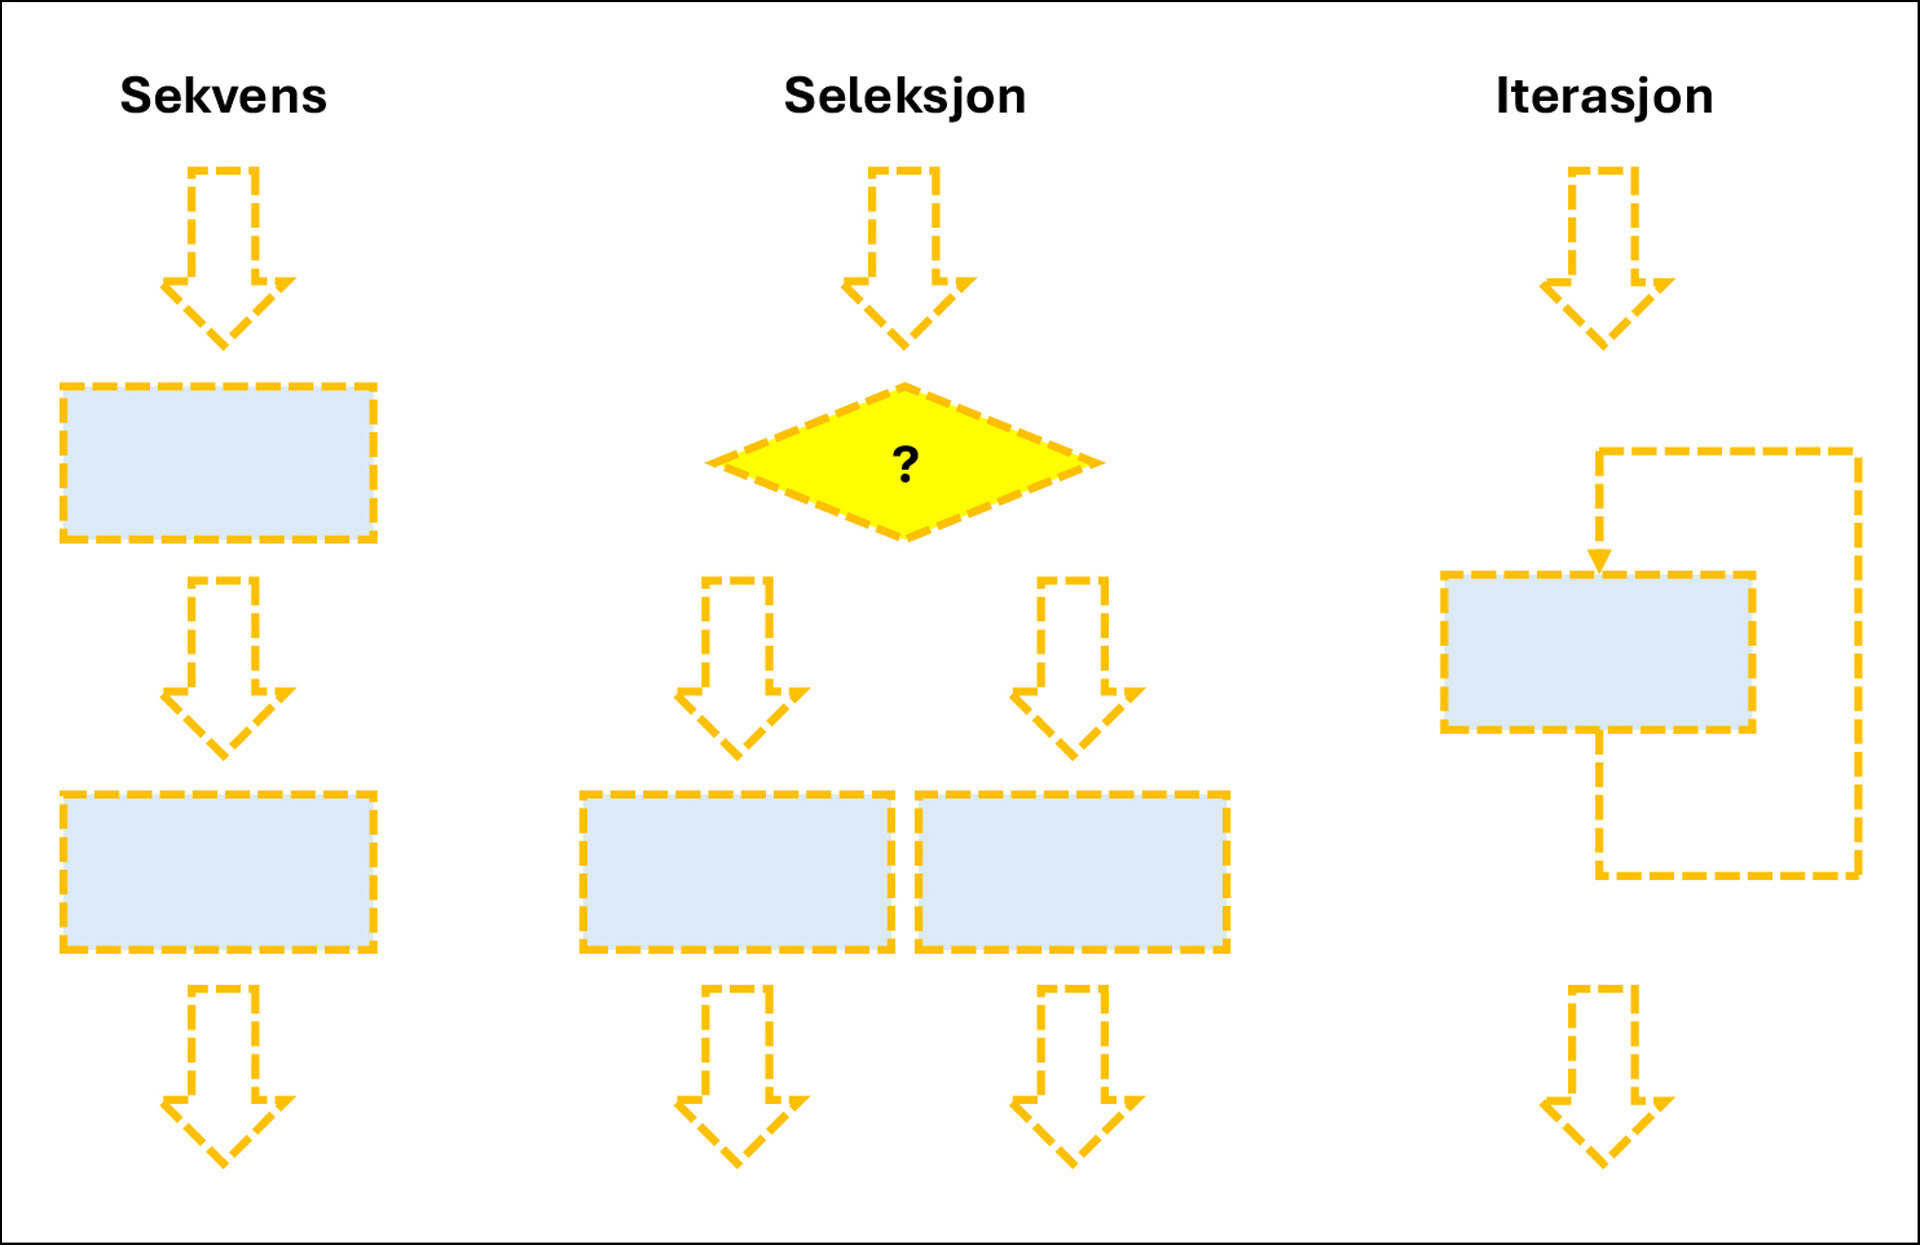
De grunnleggende byggestenene i programmering (Böhm–Jacopini theorem).
Det første steget vil være å laste inn XHTML-filen ved bruk av kommandoene «open()» og «read()». Da lastes filen fra permanent lagring i harddisken til det midlertidige minnet, i form av et objekt tilgjengelig for videre håndtering av programmet. En variabel, i illustrasjonen ovenfor navngitt «data», refererer* Variabelen peker på objektet, gjennom verdi, datatype og id. til dette objektet, og gir maskinen i praksis tilgang til en generell tekstfil med ustrukturert data.
Det neste steget er å bearbeide filen slik at programmet kan hente ut spesifikk data. På en ren tekstfil kan det gjøres enkle ordsøk i et tekstredigeringsprogram, men det vil i mange tilfeller ikke være tilstrekkelig* På en konferanse ytret en analytiker frustrasjon over at enkelte selskap utformet PDF-rapportene på en slik måte at muligheten for søk var begrenset. Merket data i en XHTML-fil vil alltid være søkbar, også i den menneskelesbare rapporten.. For dem med god kompetanse innen programmering kan de skrive en kildekode, eksempelvis i Python, basert på de elementære byggestenene sekvens, seleksjon og iterasjon, og derigjennom bygge et program tilpasset et spesifikt formål. En slik tilnærming vil imidlertid kunne være unødvendig ressurskrevende, og den vil ikke utnytte at markeringsfilers struktur følger standardiserte regler.
I stedet for å bygge en kildekode fra grunn kan det heller tas utgangspunkt i pakkene med ferdigprogrammerte funksjoner, for så eventuelt å bygge videre på dem. Disse pakkene utvikles og vedlikeholdes løpende av «åpen kilde»-samfunnet. Av disse er særlig pakken «BeautifulSoup» anerkjent for gode funksjoner for å hente data ut av markeringsfiler som XML og HTML, og er blant annet mye brukt til «web scraping».
«BeautifulSoup» inneholder funksjoner som strukturerer data fra markeringsfiler, slik at den kan tolkes og bearbeides av maskinen («parsing»). Det er imidlertid verdt å merke seg at «BeautifulSoup» er ment for generell bruk, og ikke skreddersydde XBRL-filer, så det vil kunne være behov for tilpasninger i kildekoden for å oppnå ønsket resultat* Det finnes pakker skreddersydd for XBRL i XHTML-format. De ser imidlertid ikke ut til å ha nådd tilstrekkelig popularitet til at det gjøres kontinuerlig feilsøking og vedlikehold av dem, slik som tilfellet er for «BeautifulSoup»..
3.1 Primæroppstillingene – «ix:nonFraction»
Etter bearbeiding av filen kan ønsket data hentes ut blant annet ved søk på elementer og attributter. I illustrasjonen nedenfor er rapportert innhold for «Revenue», både for rapporteringsperioden og sammenligningstall, hentet ut og lagret som en liste i et nytt objekt. Listen kan så skrives ut for å vise hvert element i listen. Ønsker man kun å vise innholdet og ikke tilhørende metadata, kan kommandoen «get_text()» legges til. I begge tilfeller er verdiene lagret og vist som ren tekst («string») og må derfor bearbeides før maskinen kan håndtere innholdet som en numerisk tallverdi.
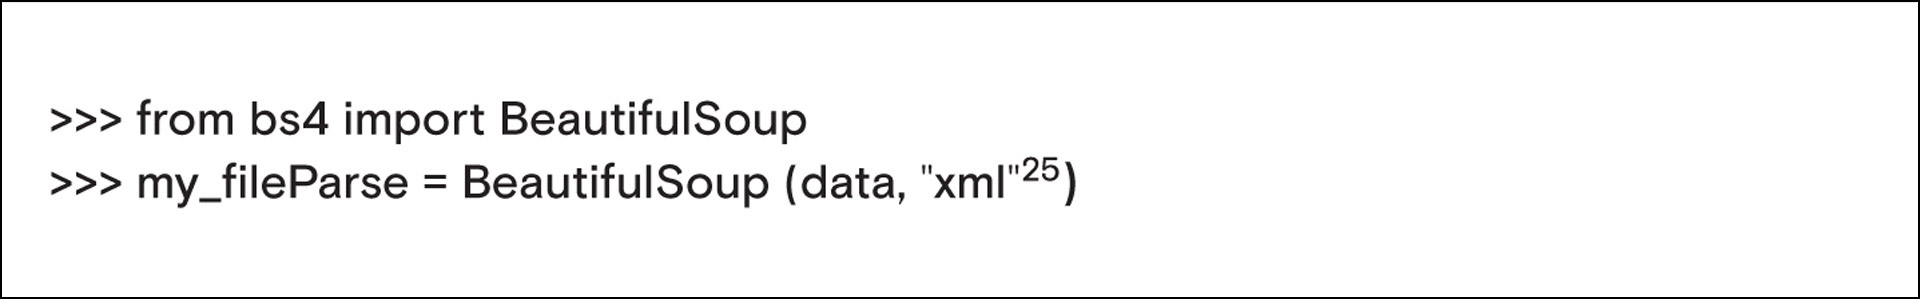
I illustrasjonen brukes en «parser» fra «BeautifulSoup» til å gjøre den innlastede filen bestående av ren tekst om til et strukturert objekt, godt egnet for søk og uthenting av spesifikk data. Variabelen «my_fileParse» refererer til det strukturerte objektet.
25. «BeautifulSoup» inneholder flere «parsers», inkludert én for HTML og én for XML. Siden XHTML etterlever både XML- og HTML-standarder, er begge mulige alternativ. Siden XML er den strengeste standarden, er det i dette tilfellet vurdert hensiktsmessig å bruke XML-parser.
Elementene i illustrasjonen ovenfor viser ikke all relevant data. Eksempelvis årstall, som knytter innholdet til rapporteringsperioden eller sammenligningstallene, vises ikke i elementet. Dette skyldes ikke programmet, men hvordan XBRL-rapporten er utformet. For å unngå dataredundans, hvor samme data gjentas unødig gjennom XHTML-filen, samles enkelte data i en separat seksjon i filen* Elementene markert med ix:resources og ix:references inneholder data som ikke skal gjengis av en nettleser i den menneskelesbare rapporten, men som en maskin behøver for å tolke data. Nettleseren skal ikke gjengi denne dataen i den menneskelesbare rapporten, noe som kan oppnås eksempelvis ved å legge til «div style=none» før elementet., inkludert årstall. I stedet for å oppgi rapporteringsperioden for hvert element, inneholder attributten «contextRef» en henvisning til denne separate seksjonen, hvor data om årstall ligger.
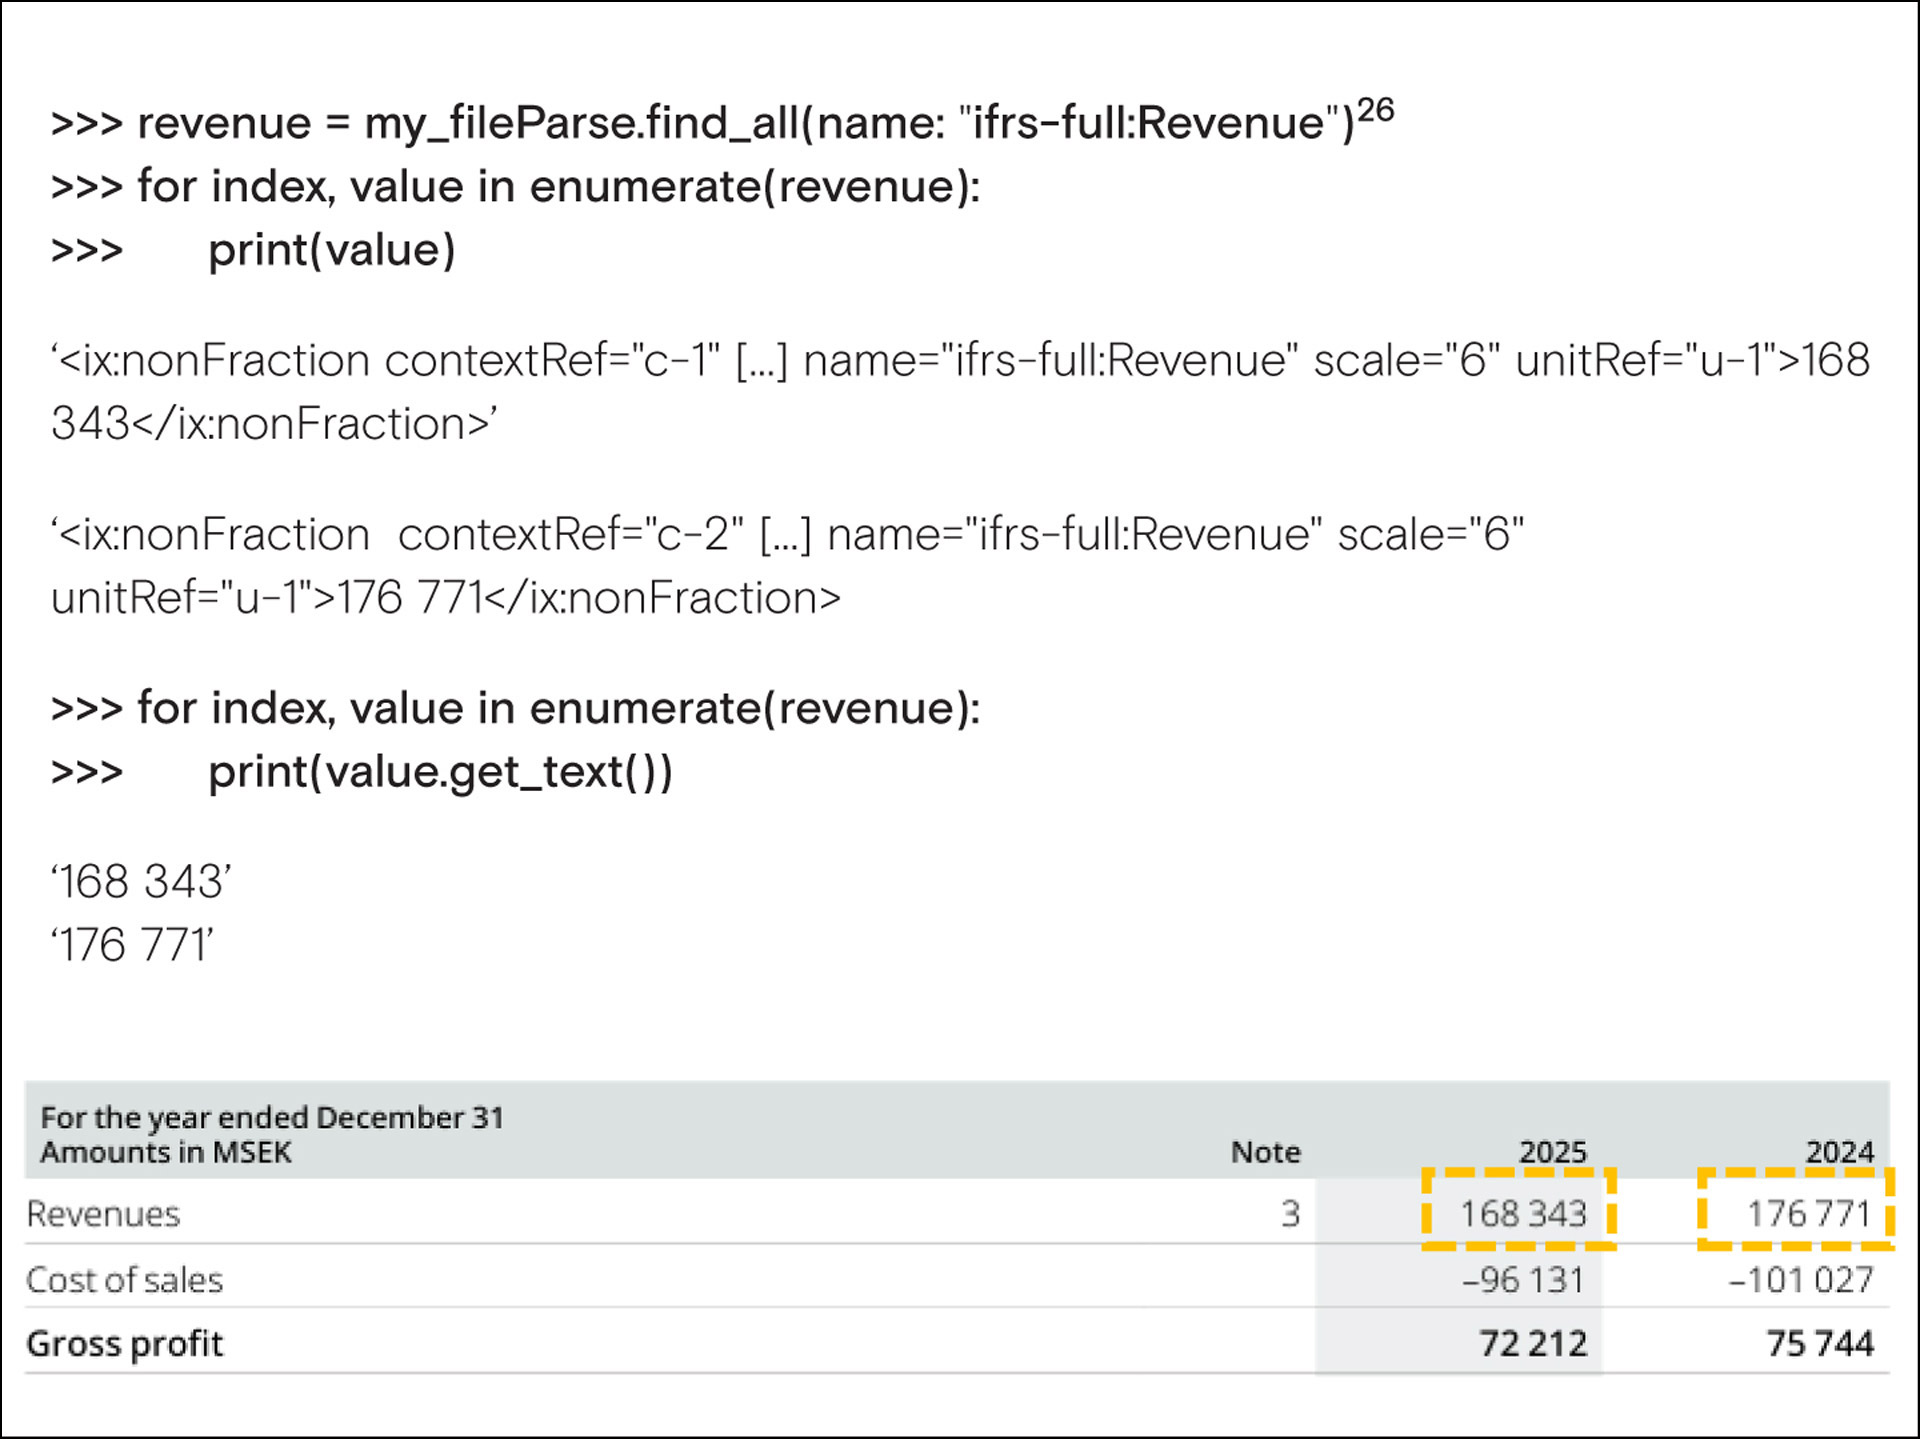
Illustrasjonen viser maskinell uthenting av elementer merket med «ifrs-full:Revenue». Variabelen «Revenue» refererer til objektet bestående av listen av elementer. Gjennom en iterasjon som skriver ut hele listen, vises hvert element.
26. Formlene er noe forenklet, for tydelig å vise hvordan attributter kan brukes for å hente ut data. Siden attributtnavnet «name» allerede er i bruk i selve funksjonen hentet fra «BeautifulSoup», må attributtet «name» legges inn i en «attrs»-funksjon: attrs={«name»: «ifrs-full:Revenue»}.
Å hente ut data på denne måten kan virke tungvint, særlig sammenlignet med det å finne tallet i den menneskelesbare rapporten. Nytteverdien kommer imidlertid til syne ved egendefinerte analyser og sammenligninger på tvers av selskap og bransjer, som må gjentas ved jevne mellomrom. Gjennom en eksisterende kildekode, gjerne kombinert med API for nedlasting av ESEF-rapporter, vil den samme øvelsen kunne gjentas jevnlig, uten å være særlig ressurskrevende.
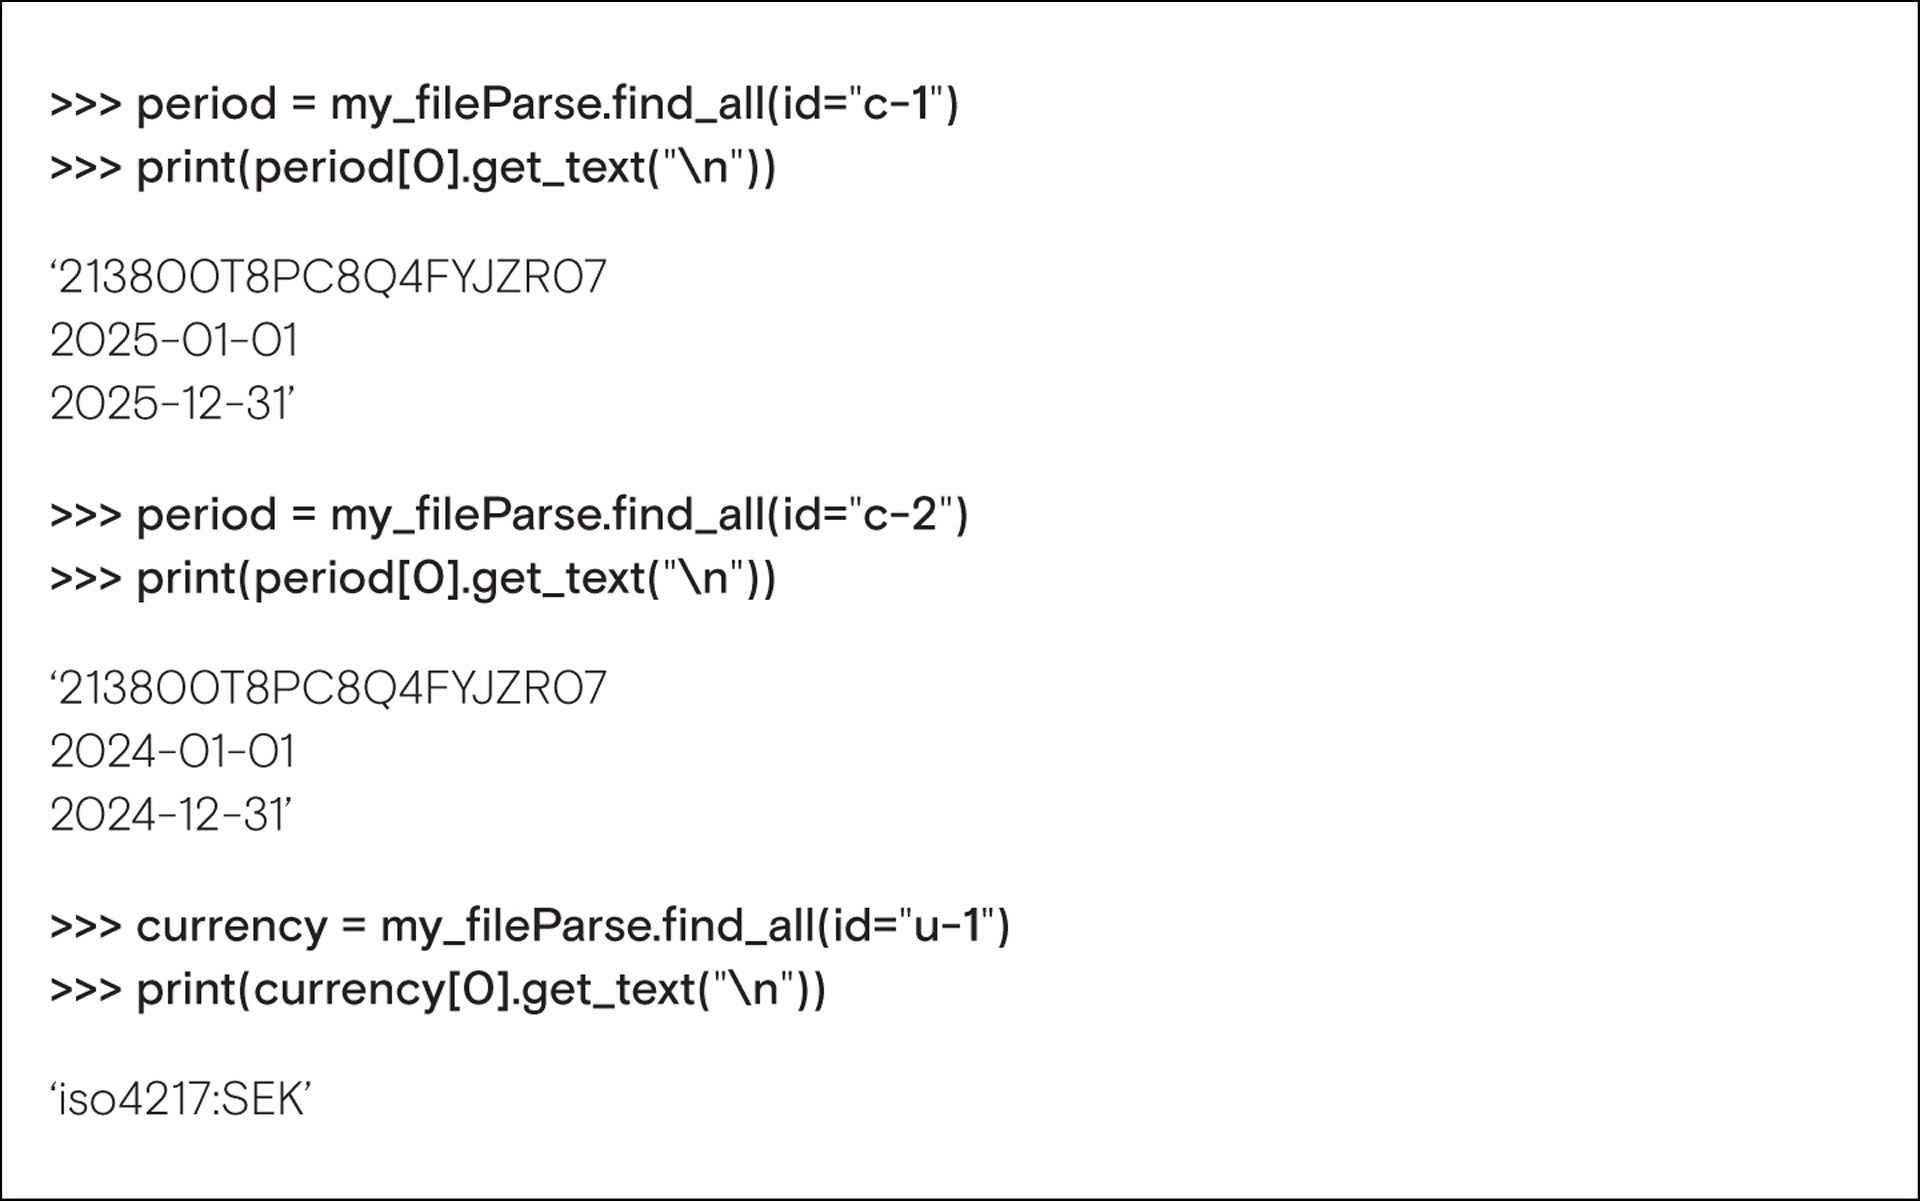
Illustrasjonen viser hvordan data om periode og valuta kan hentes ut ved bruk av attributten «id».
Med egendefinerte analyser gis regnskapsbrukeren mulighet til å strukturere data på en måte som dekker regnskapsbrukernes informasjonsbehov, eksempelvis ved å gjøre analyse på forholdstall eller å sette opp egne delsummer og resultatmål.
I illustrasjonen beregnes en rentabilitet basert på «Profit or Loss». Enkelte foretrekker imidlertid et annet rentabilitetsmål enn regnskapsmessig egenkapitalavkastning. Andre resultatmål, eksempelvis driftsresultat eller (adjusted) EBITDA etter investeringer, vurdert mot sysselsatt kapital, kan for enkelte være et mer ønskelig informasjonsgrunnlag. Rentabiliteten vurderes så mot et avkastningskrav for å vurdere virksomhetens lønnsomhet.
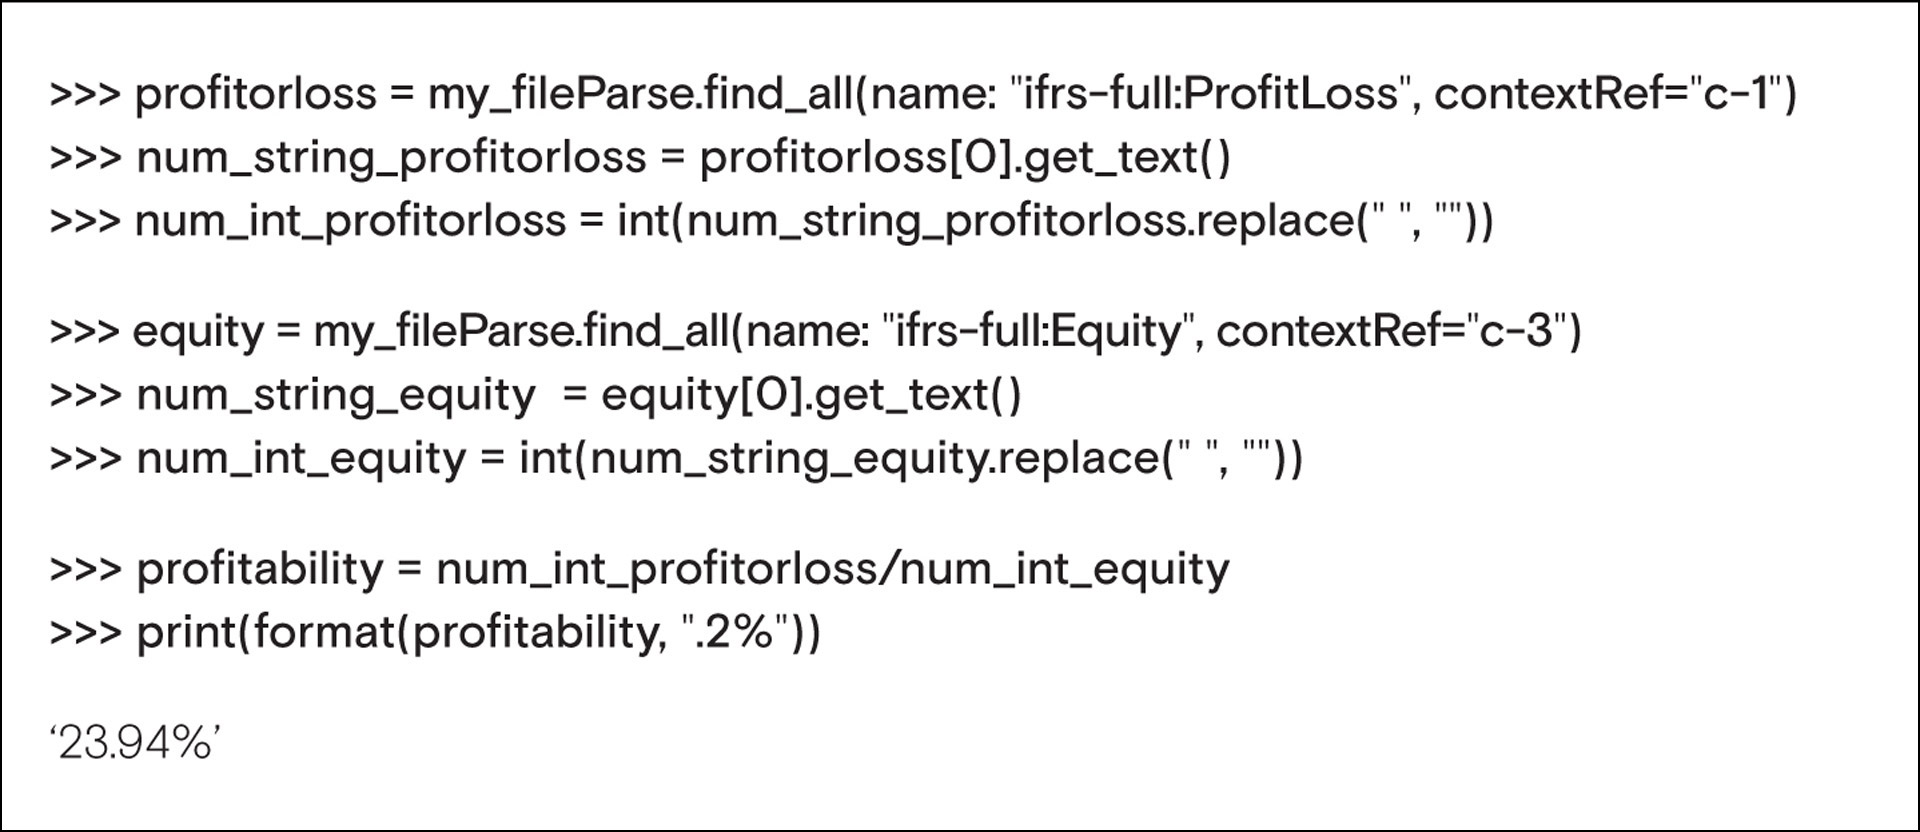
For å beregne rentabilitet må innholdet først hentes ut fra tekstfilen, for så å omformes fra tekst («string») til en numerisk datatype som er egnet for matematiske funksjoner. Her gjøres tekst om til heltall («integers») før rentabilitet beregnes.
Det er imidlertid en utfordring at resultatmål som ikke er definert av IAS 1, ikke nødvendigvis er konsistente på tvers av selskap og bransjer. Når det gjelder APM-er, eksempelvis (adjusted) EBITDA, vil de ofte ligge utenfor finansregnskapet, og dermed ikke være gjenstand for krav til merking. Begge disse ulempene gjør at det maskinlesbare formatet, slik det foreligger nå, ikke nødvendigvis dekker behovet til disse brukerne. Håpet er at implementeringen av IFRS 18, med nye krav til resultatmål, vil kunne forebygge noen av disse ulempene. Mer om dette senere.
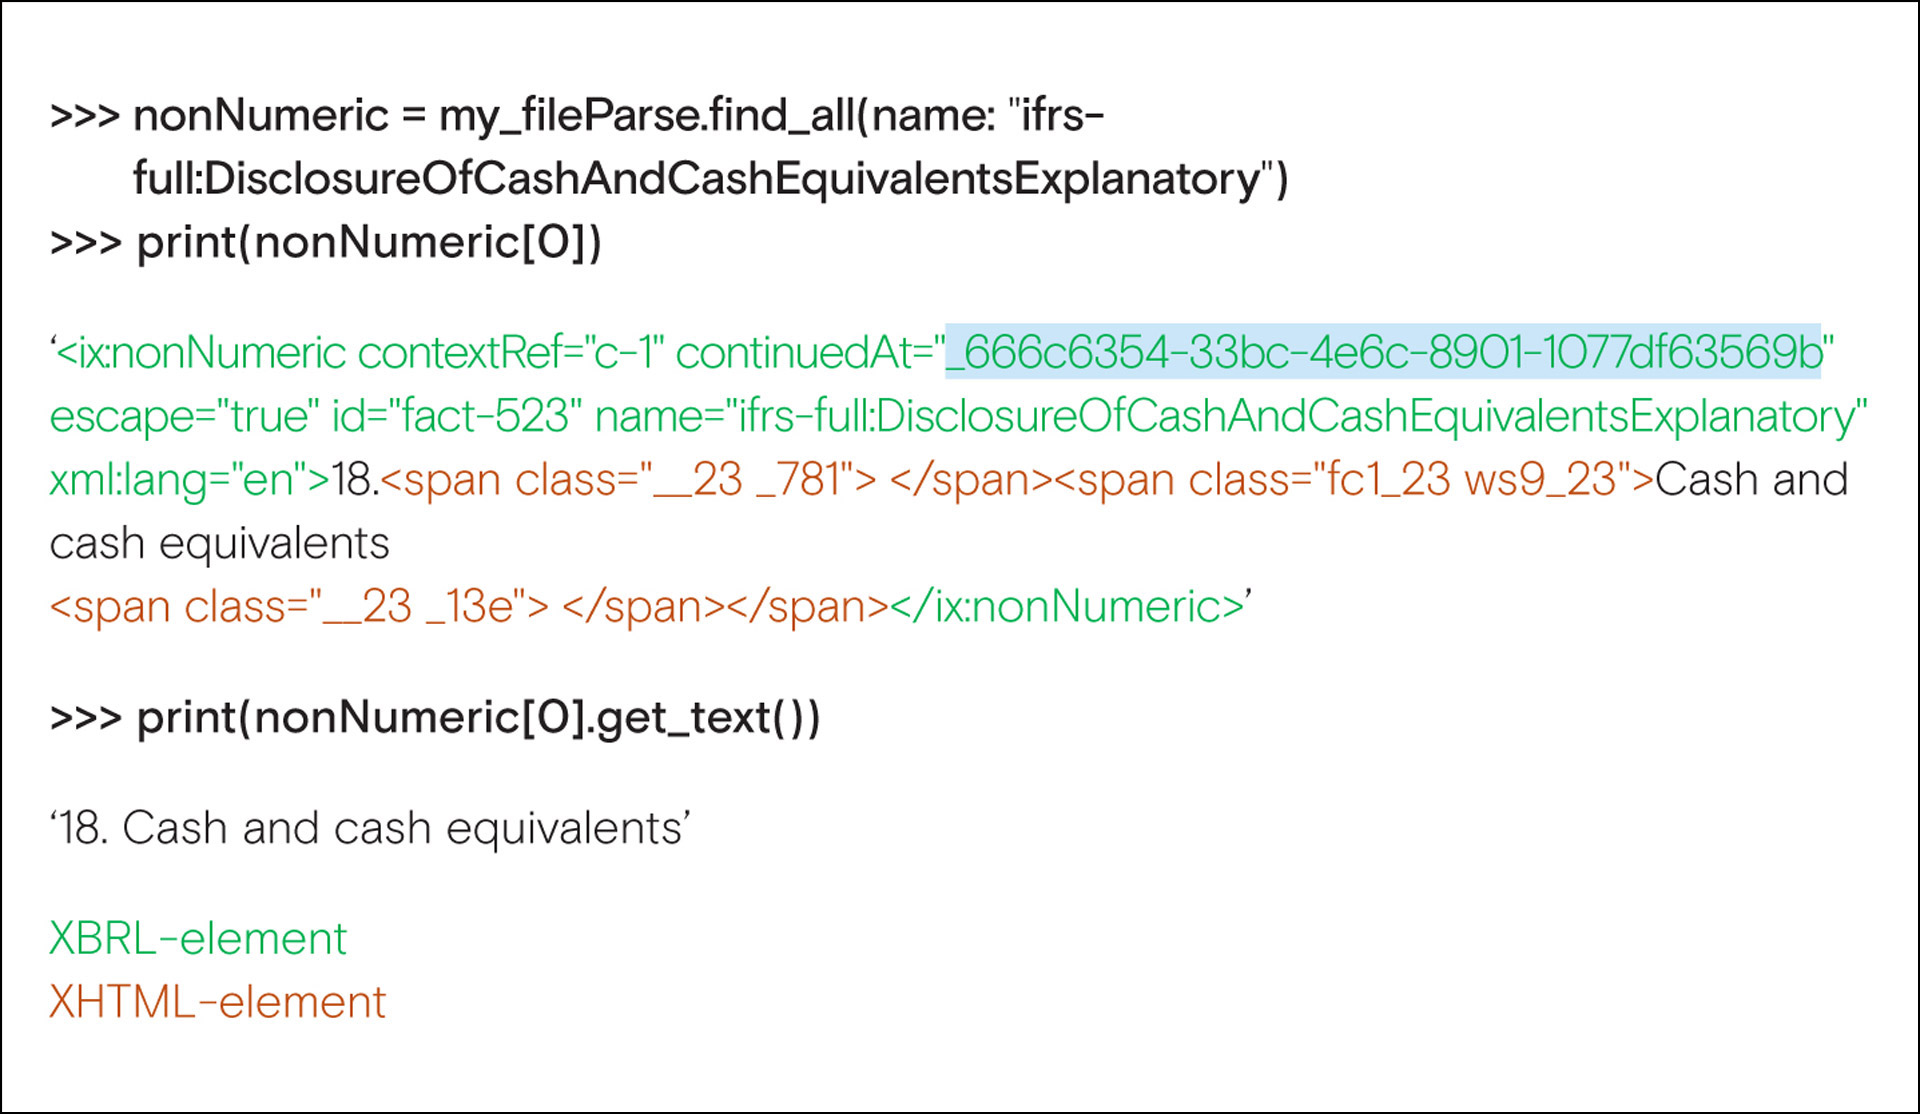
Illustrasjonen viser hvordan XHTML-elementer legges inn mellom XBRL-elementer, for å oppnå ønskelig struktur i den menneskelesbare rapporten. Å hente ut innholdet kan gjøres ved å legge til kommandoen .get_text().
3.2 Noteinformasjon – «ix:nonNumeric» og «ix:continuation»
I motsetning til primæroppstillingene hvor alle tall merkes i detalj, krever ESEF kun blokkmerking av notene. For at XHTML-filen også skal kunne brukes til å gjengi en menneskelesbar rapport, må XBRL-elementene deles opp i flere deler i blokkmerkingen. Dette for å gi rom til XHTML-elementer som blant annet skal definere stil og struktur i den menneskelesbare rapporten, inkludert tekststørrelse, tabeller, skrifttype, farger og avsnitt. Disse elementene faller utenfor XBRL-standarden* I motsetning til filings hos US SEC som må etterleve strenge format- og stilregler, har det i Europa vært tradisjon med særegne format på årsrapportene, gjerne med utstrakt bruk av bilder, farger og tekststiler. Problemstillingen med blokkmerking er derfor mindre hos US SEC enn under ESEF (XBRL International, 2024)..
For å hente ut noteinformasjon kan man ta utgangspunkt i samme funksjoner fra «BeautifulSoup» som ovenfor. Men som illustrasjonen ovenfor viser, vil man da kun hente ut første del av noten.
For å sette hele noten i blokkmerkingen sammen i et maskinlesbart format, er det mulig å legge til en iterasjon til «BeautifulSoup»-funksjonen, som setter delene sammen* Ved å bruke verdiene i attributtene «continuedAt», som vil være «Id»-attributten til neste del, kan delene knyttes sammen maskinelt. Det første XBRL-elementet i en blokkmerket note har startmerket «ix:nonNumeric», mens de resterende delene har startmerket «ix:continuation».. På denne måten opprettes et objekt bestående av en liste med alle delene av noten som gjør at man kan hente frem de delene av noten man måtte ønske, eventuelt vise hele noten maskinelt. I illustrasjonen nedenfor er derimot hver enkelt del hentet direkte fra filen, i stedet for å sette dem sammen i en fullstendig liste.
I illustrasjonen er to elementer fra noten skrevet ut. Av det første elementet ser man at ren tekst kan gjengis maskinelt med samme struktur som i den menneskelesbare rapporten. Det andre elementet viser derimot at tabeller ikke nødvendigvis gjengis på en god måte. Dataen leses maskinelt inn som ren tekst, til tross for at det er presentert i den menneskelesbare rapporten som en tabell med tall. Årsaken er at selve strukturen i den menneskelesbare rapporten ikke defineres av XBRL-elementene, men av XHTML-elementene. Dette er en konsekvens av blokkmerking på tabeller, i stedet for detaljert merking* US SEC krever detaljmerking av tall i tabeller i noter (SEC, 2009)..
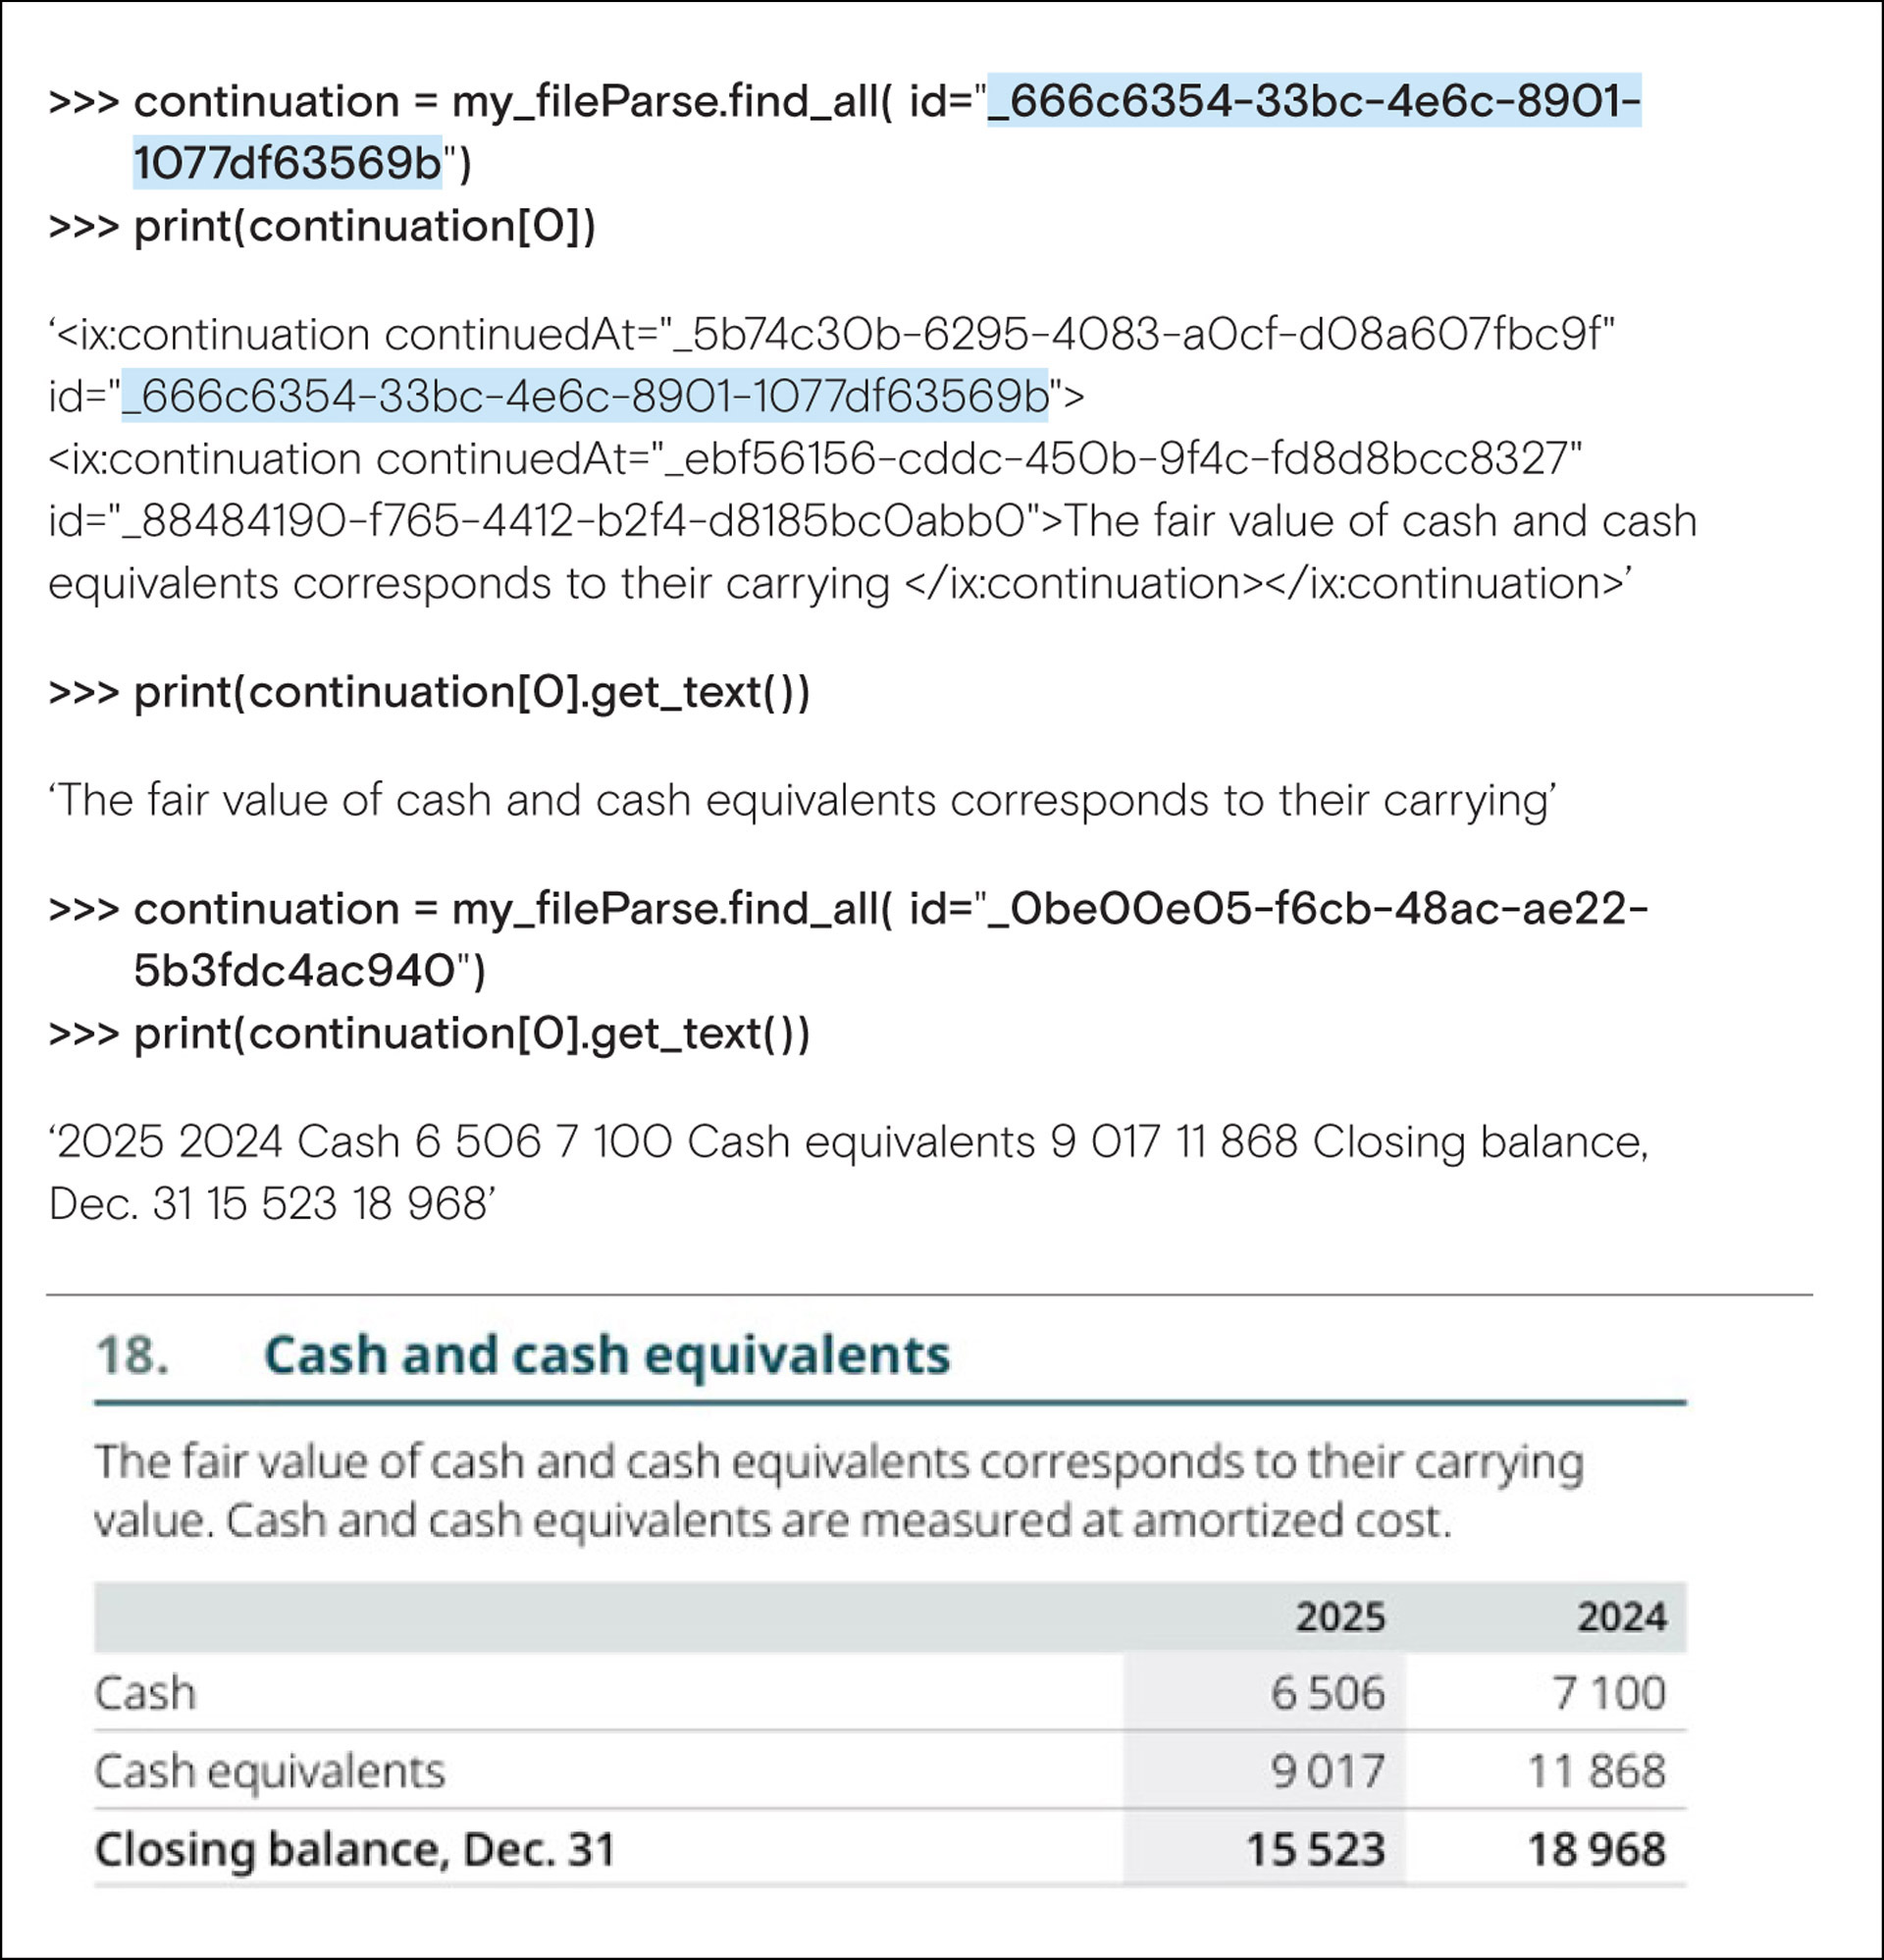
Illustrasjonen viser at tekst kan hentes ut maskinelt på en god måte ved å legge til kommandoen .get_text(). For tabeller og tall faller imidlertid tabellstrukturen bort. Ved blokkmerking inneholder ikke XBRL-elementene strukturen, men det er mulig å inkludere dette gjennom noe mer kildekode som også hensyntar XHTML-elementene, hvor tabellstrukturen ligger.
For å bevare tabellstrukturen ved bruk av maskinlesbar data, må XHTML-elementene inkorporeres i kildekoden. Det er fullt mulig å gjøre det, men siden tabeller kan settes opp på ulike måter* Forskjellen på strukturelle elementer og presentasjonselementer, samt ESMAs anbefaling knyttet til valget, beskrives senere i artikkelen., vil det være vanskelig å skrive kildekode som håndterer dette konsistent. Siden XHTML-elementene ikke dekkes av XBRL-standarden, vil standarden ikke sikre at utstederne gjør dette på samme måte. Den infrastrukturen som skal åpne for effektiv bruk av teknologiske verktøy, gjennom en bred obligatorisk merking med standardiserte krav, vil da mangle (XBRL International, 2024).
Estimater er en god måte å eksemplifisere dette på. En regnskapsbruker kan ønske å sammenligne forutsetninger og sensitiviteter, eksempelvis for nedskrivningsvurderinger eller bransjespesifikke estimater. Ved å bruke XHTML-merkingen som ligger i filen, er det mulig å gjenskape tabellen. Men så lenge tabellene ikke er satt opp med samme type XHTML-element, samt at forutsetningene ikke er konsistent merket eller navngitt, blir det krevende, tilnærmet umulig, å skrive en kildekode som alltid håndterer dataen på riktig måte på tvers av enheter. Da blir det vanskelig å gjennomføre en slik sammenligning maskinelt på en mer effektiv måte enn ved bruk av den menneskelesbare rapporten (ESMA, 2024) (XBRL International, 2024).
Denne ulempen er uheldig da bruken av tabeller ofte er en hensiktsmessig måte å kommunisere informasjon på i en menneskelesbar rapport. Dette ble også lagt vekt på i IASBs rapport om «Better Communication in Financial Reporting» fra 2017, hvor det ble oppmuntret til økt bruk av tabeller og illustrasjoner for å kommunisere informasjon i regnskapet. At viktig informasjon derfor ligger i tabellene, og ikke i notens øvrige tekst, er derfor rimelig å legge til grunn. Også ESMA anerkjenner at det på området er noe motstridende mål (ESMA, 2016).
Når man ser de klare ulempene med blokkmerking, er det legitimt å stille spørsmålet om merking av noteinformasjonen virkelig gir regnskapsbrukerne en nytte som overstiger utstedernes kostnader. For utsteder er det trolig vesentlig mer ressurskrevende å merke noteinformasjonen enn det er å merke tallene i primæroppstillingene. Det gjøres sjelden større endringer på strukturen i primæroppstillingene, mens noteinformasjonens innhold og omfang endres fra år til år.
At noteinformasjonen er viktig for regnskapsbrukerne, er det imidlertid liten tvil om. Gjennom IASBs arbeid med standardsetting ser det stort sett ut til at brukerne av regnskapet, inkludert investorer, heller ønsker mer enn mindre noteopplysninger. Det er derfor forståelig når ESMA krever merking av noteinformasjon, fordi det er nødvendig for at brukerne skal få en full forståelse for et selskaps situasjon, også gjennom et maskinlesbart format (ESMA, 2015).
Samtidig må det legges vekt på at blokkmerking er fornuftig ved at det reduserer ressursbruken for utstederne, til sammenligning med detaljert merking. Det er også verdt å merke seg at det ikke virker å være konsensus rundt hva som er den mest egnede tekniske løsningen for noteinformasjon, i motsetning til primæroppstillingene hvor det er forholdsvis stor grad av enighet rundt beste løsning. Det sees derfor på løsninger for hvordan man kan videreutvikle merkingen av noter, noe som vil beskrives senere i artikkelen.
3.3 Bruk av Namespace
Som illustrert i de to foregående avsnittene, kan spesifikk data hentes ut direkte fra XHTML-filen. Det er imidlertid også fullt mulig å hente ut all maskinlesbar XBRL-data i sin helhet. Inline XBRL-dokumentet inneholder i praksis en fullstendig maskinlesbar rapport* I XBRL definert som et «target document» (XBRL International, 2022). som etterlever kravene i XBRL 2.1-spesifikasjonen. Denne maskinlesbare rapporten er imidlertid spredt utover i XHTML-filen, innimellom XHTML-elementer.
Å hente ut den maskinlesbare rapporten kan gjøres ved å bruke «namespace»-funksjonen innebygd i XML. For XBRL-element brukes blant annet prefikset <ix:, eksempelvis <ix:nonFraction og <ix:nonNumeric. Denne prefikset gjør det mulig å skille element knyttet til XBRL fra øvrige element i XHTML-filen, og kan dermed brukes til uthenting av ønsket data, også ved bruk av «BeautifulSoup».
På samme måte vil alle elementer der name-attributtet knyttes til IFRS-taksonomien ha prefiks «ifrs-full:, eksempelvis ‘<ix:nonFraction name=”ifrs-full:Revenue” id=”fact-3…’. Det gjør det mulig å hente ut all data merket med den definerte taksonomien, men også mulig å skille taksonomier hvis det blir brukt flere. Hvilke muligheter det gir, beskrives noe mer under «XBRL også for ikke-noterte selskaper».
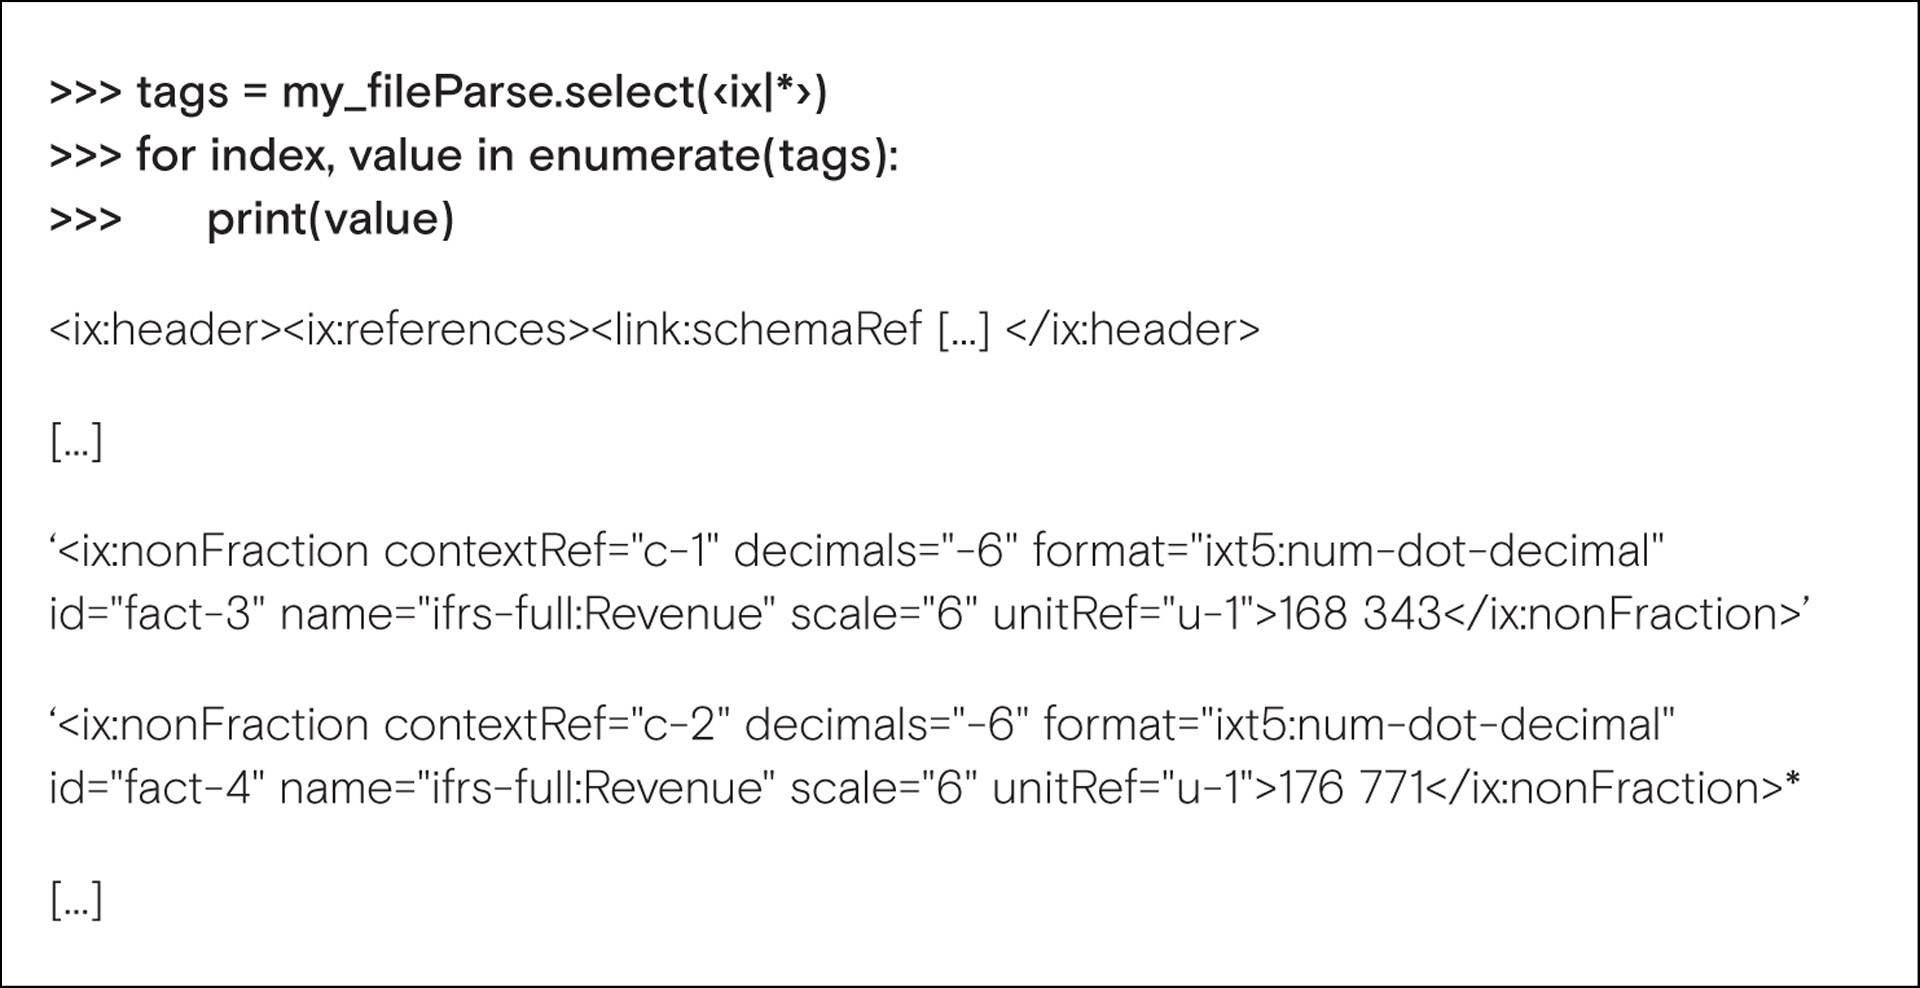
I illustrasjonen hentes alle XBRL-elementer fra XHTML-filen og lagres i et objekt bestående av en liste. Variabelen «tags» refererer til listen. Kun et fåtall av de elementene som skrives ut, er av plasshensyn vist i illustrasjonen.
4. Veien videre
Som beskrevet ovenfor, er det noen utfordringer knyttet til ESEF i sin nåværende form. Disse utfordringene begrenser nytteverdien for enkelte brukere, så det bør sees på mulige løsninger som ikke er for ressurskrevende for utstederne. I det følgende beskrives enkelte områder for mulig videreutvikling av ESEF og XBRL.
4.1 Merking av noter
ESMA har notert seg utfordringene knyttet til merking av noteinformasjon, og de ser at brukerne ikke har vært i stand til å utnytte merket noteinformasjon fullt ut. I et høringsnotat offentliggjort i 2024* «Feedback statement» er ennå ikke offentliggjort. er ett av formålene* Det primære formålet med høringsprosessen virker å være merking av bærekraftsinformasjon. å se på hvilke løsninger som finnes på disse utfordringene. Et godt utgangspunkt er å forstå hva merket noteinformasjon er og kan bli brukt til (ESMA, 2024).
I 2024* Siden særegne format på årsrapportene er vanligere i Europa enn hos US SEC-selskap, ble utfordringene med blokkmerket noteinformasjon tydeligere etter at obligatorisk merking av noteinformasjon under ESEF trådde i kraft. offentliggjorde XBRL International et notat som blant annet identifiserte ulike bruksområder for blokkmerket noteinformasjon. Bruksområdene omfattet isolert gjengivelse av enkeltnoter («isolated rendering»)* Isolert gjengivelse gjør det mulig å sammenligne noter side om side. XBRL er imidlertid tydelig på at det å beholde stilen på noten, inkludert bilder og illustrasjoner, ikke er et mål ved maskinell bruk av data, inkludert ved isolert gjengivelse., økte muligheter for søk og orientering («navigation and highlighting»), automatisert tekstanalyse* Ren tekst kan være nyttig input for ulike typer analyser, eksempelvis semantisk analyse, «data mining» og «natural language processing» (KI). og grunnlag for fullstendighetstest («Disclosure check list»* Utfordringen med en maskinell fullstendighetssjekk av noteopplysningene er å ta høyde for selskapets vurdering av vesentlighet, samt at noteinformasjonen skal være selskapsspesifikk og ikke generell. /«Disclosure indicator»). ESMA har i høringsnotatet inkludert denne informasjonen når de ser på alternativer for videre utvikling (XBRL International, 2024) (ESMA, 2024).
Endelig utfall av høringsprosessen kan potensielt medføre større endringer, eksempelvis krav til mer detaljert merking av noter. I mellomtiden har ESMA gjort enkelte tiltak for å gjøre rapportene, og særlig tabeller i noter, mer egnet til bruksområdene beskrevet ovenfor. Slik kravene er i dag, er det mulig å benytte både «strukturelle elementer», som <table>, og «presentasjonselementer»* For en XHTML-fil utarbeidet på grunnlag av en ordinær PDF vil presentasjonsmerking være egnet for å gjenskape en menneskelesbar rapport tilsvarende den ordinære PDF. Til sammenligning vil XHTML-filer utarbeidet direkte fra årsoppgjørssystemet i større grad bruke strukturelle merker., eksempelvis <span> og <div>, for å få en nettleser til å gjengi en tabell i den menneskelesbare rapporten. For maskinell bruk er de strukturelle elementene mer hensiktsmessige for å bevare eksempelvis tabellstrukturen. At disse benyttes i stedet for «presentasjonselementer», anbefales nå av ESMA, men over tid kan det fort bli et krav (ESMA, 2025).
Mens ESMA vurderer alternativer, kan det også være fornuftig for utstederne å se på hvilke muligheter som finnes for å gjøre den maskinlesbare rapporten mer tilgjengelig og nyttig for brukerne. At utstederne i større grad forutsetter at regnskapet også skal kunne leses av en maskin, ikke bare av personer, kan bidra til å påvirke hvordan notene utformes.
Det er heller ikke forbud mot detaljmerking av noteinformasjon, inkludert tabeller. Men uten et obligatorisk krav kan det imidlertid ikke forventes at alle detaljmerker på frivillig basis. Det vil begrense brukernes mulighet for sammenligninger på tvers av selskap og bransjer, som vil være en av de viktigere bruksområdene for maskinell bruk av detaljmerket data. Da spørs det om ressursbruken gir tilstrekkelig nytte til å forsvare kostnaden.
4.2 APM – Nye krav etter IFRS 18
At alternative resultatmål (APM) stort sett ikke merkes, eventuelt bare blokkmerkes, ble trukket frem som en klar ulempe i høringssvarene tilbake i 2016* Som påpekt i høringssvar, inkludert 88 svar fra organisasjoner i Frankrike, tar IFRS-taksonomien ikke høyde for APM.. Den utstrakte bruken av APM tilsier at det foreligger et vesentlig informasjonsbehov som ikke dekkes av resultatmålene definert av IFRS. Både egenkapitalinvestorer og långivere ser ut til å ønske mer eller annen type informasjon enn den de får av resultatmål definert av IFRS. Derfor er det ikke utenkelig at enkelte investorer fortsatt vil ha behov for databehandlere, for å få informasjonen fra APM-er på et mer anvendelig elektronisk format (EFRAG, 2014).
ESMA anerkjenner APM-er som en informasjonskilde som supplerer resultatmål definert av IFRS. Det har derfor ikke vært ønskelig med et forbud, men det er gjort tiltak for å sikre at informasjonen ikke misleder brukeren eller tilslører («obscure») vesentlig informasjon* Det refereres til ESMAs veiledning «Guidelines on Alternative Performance Measures (2015)».. Praksis er imidlertid ikke fullt ut ensartet, både med tanke på valg av APM, samt måling og presentasjon av disse. APM-er ligger derfor ikke i et rammeverk som er godt egnet for merking og digital rapportering (ESMA, 2015).
ESMA trakk imidlertid frem at ESEF ikke begrenser merking av APM, og at det er fullt mulig å bruke egendefinert merking («extensions»), samt detaljert merking som alternativ til blokkmerking. Også her vil en slik frivillig løsning trolig ikke være en god løsning. Uten et obligatorisk krav kan det ikke forventes at alle detaljmerker, noe som igjen begrenser brukernes mulighet for sammenligninger på tvers av selskap og bransjer (ESMA, 2016).
IASB forventer at implementeringen av IFRS 18 «Presentation and Disclosure in Financial Statements» vil bidra til forbedret digital tilgang til finansiell informasjon. Viktige relevante resultater inkluderer mer ensartet praksis rundt presentasjon, flere obligatoriske resultatmål og et rammeverk for «Management Performance Measures» (MPM)* Resultatbaserte APM-er som er «...subtotal of income and expenses...». (IFRS 18.117).. I denne sammenheng er rammeverket for MPM, en viktig underkategori av APM, spesielt viktig. Det sikrer at MPM blir del av regnskapet, samt at MPM i note må avstemmes mot nærmeste resultatmål definert av IFRS. Dette gir en standardisert tabell godt egnet for merking og digital rapportering (IFRS 18.123 (c)) (IFRS® Foundation, 2024).
IASB har i taksonomien for 2025 inkludert detaljerte merker som kan benyttes for merking av MPM-tabellen, i tillegg til den ordinære blokkmerkingen. Hvorvidt ESMA vil kreve detaljert merking av tabellen, er fortsatt uklart. Her er det imidlertid gode muligheter for å forbedre regnskapsbrukers mulighet til maskinell behandling av denne dataen. For å forstå hvordan slik detaljert merking kan fungere, er det mulig å se på hvordan egenkapitaloppstillingen merkes i dag* XBRL 2.1 er supplert med standarden «XBRL Dimensions 1.0» som definerer hvordan seksjonene under <segment> og <scenario> skal brukes. For å gjenskape rekkefølgen i tabellstrukturen, må også linkbase trekkes inn. (IFRS® Foundation, 2025).
4.3 XBRL også for ikke-noterte selskaper
Som beskrevet innledningsvis, så EU-kommisjonen for seg en bredere innføring av rapportering i tråd med XBRL, som ikke var begrenset til utstedere. En bred innføring kunne vært et godt bidrag til EUs ambisjon om at informasjon kun må rapporteres én gang, selv om det skal brukes til flere formål og av ulike myndighetsorgan («once-only principle»). Flere kjenner seg nok igjen i at dagens rapporteringskrav for næringslivet tidvis er overlappende, så her er det rom for forenklingstiltak for næringslivet.
XBRL åpner for at generell rapportering av regnskapsinformasjon kan suppleres med ytterligere XBRL-data, for å dekke et særskilt rapporteringsformål. Denne supplerte dataen må ikke nødvendigvis reflekteres i den menneskelesbare rapporten, men kan også bare være tilgjengelig gjennom maskinell uthenting. Da kunne myndigheter heller krevd at XBRL-data ble supplert med den dataen de måtte ha behov for, eventuelt med en separat taksonomi, slik at de kunne hentet data gjennom API-spørringer på regnskapsregisteret, i stedet for å kreve separat rapportering. Dermed ville selskap kunne dekket flere rapporteringskrav med én rapport og én innsendelse, noe som ville redusert ressursbruken både hos selskapene og brukerne, samt redusert risikoen for feilaktig rapportering (XBRL International, 2025).
Selv om EU ikke innførte et bredere krav til rapportering etter XBRL, er det fullt mulig for medlemsstatene å gjøre det på eget initiativ. Kostnadene ved en slik innføring ville ikke nødvendigvis vært så høye, da regnskapslovens oppstillingsplan kunne støttet en forholdsvis sømløs innføring av merking av primæroppstillingene. Det finnes flere land som på eget initiativ har innført dette i nasjonal lovgivning, og man skal ikke lenger enn til Danmark for å se et eksempel på mulighetene en slik innføring kan gi (XBRL International, 2022).
4.4 Krav til merking av øvrig periodisk rapportering
Kravet til elektronisk rapportering er begrenset til årsrapporten. Den lovpålagte halvårsrapporten, samt eventuelle kvartalsrapporter, er ikke gjenstand for tilsvarende krav. Til sammenligning krever US SEC XBRL-merking av både kvartals- (10-Q) og årsrapportering (10-K), i tillegg til tilsvarende merkingskrav for enkelte andre rapporteringsforpliktelser til markedet (SEC, 2009).
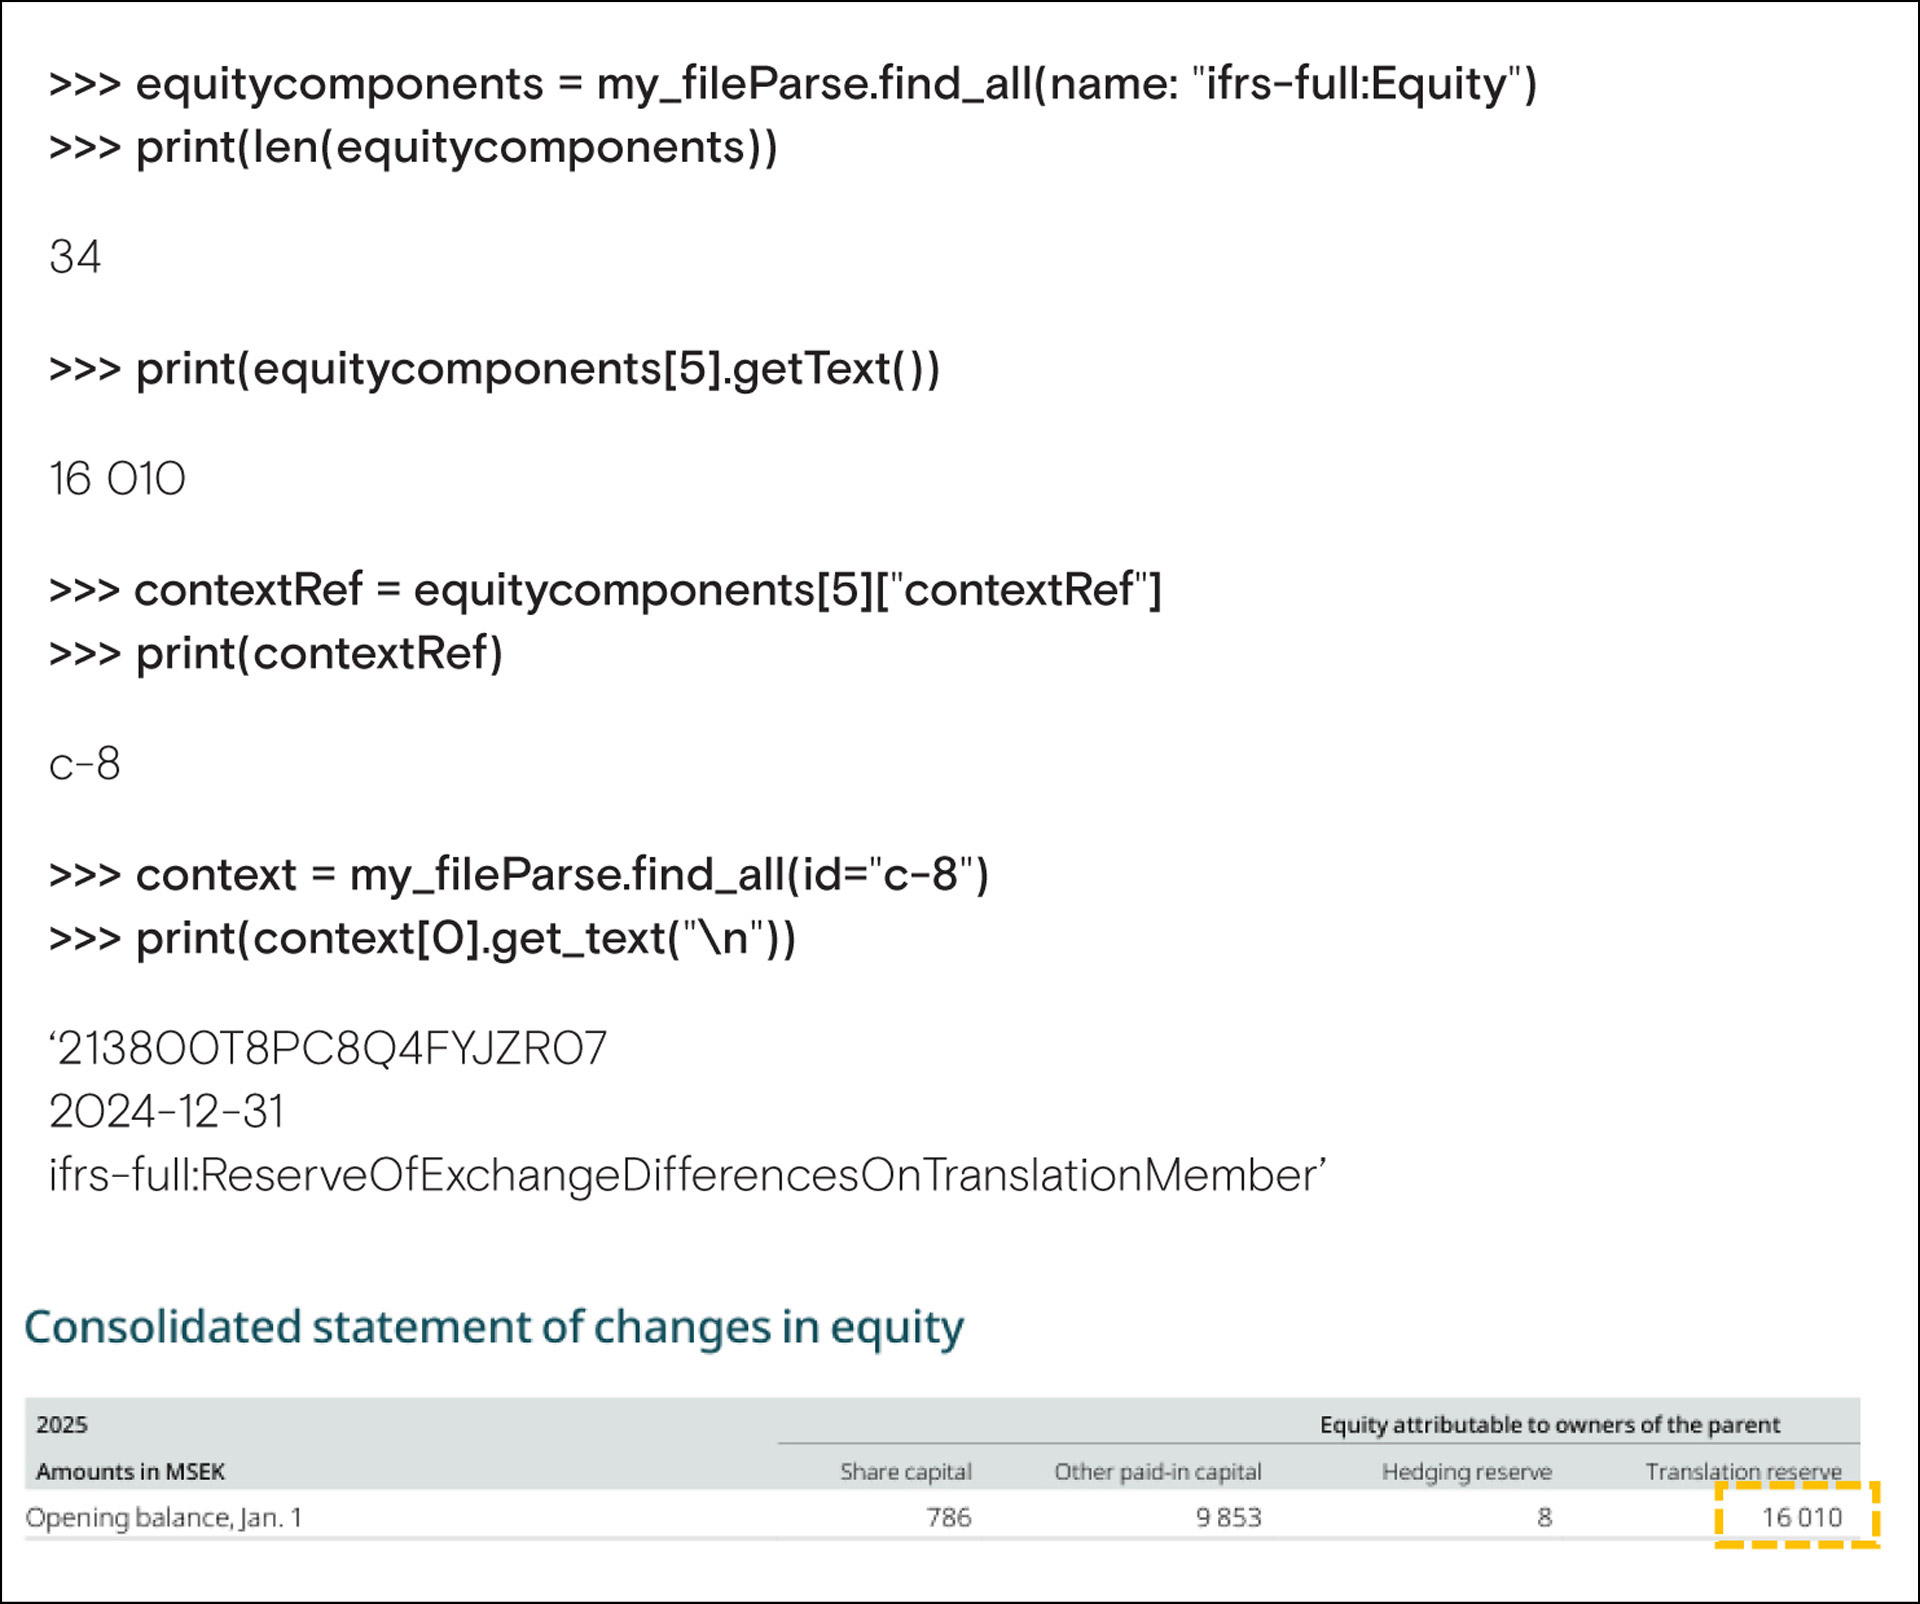
Illustrasjonen viser at spørring på «ifrs-full:Equity» gir en liste på 34 markerte element. Disse 34 består av tallene i balansen, samt alle tallene i egenkapitaloppstillingen knyttet til de samme balansetallene. Disse elementene skilles fra hverandre gjennom attributten «contextRef», som inneholder data om hvor elementet hører hjemme.
For en regnskapsbruker som skal bruke informasjon fra periodisk rapportering til kortsiktig gevinst, er det avgjørende at informasjonen fra utsteder gjøres tilgjengelig på et elektronisk format ved første offentliggjøring. Siden kvartalsrapportene ikke merkes, og de fleste velger å offentliggjøre en rapport for fjerde kvartal i god tid før selve årsrapporten offentliggjøres, vil informasjonen være tilgjengelig i markedet før den elektroniske rapporteringen offentliggjøres. Det innebærer at denne type investorer fortsatt må belage seg på å bruke den menneskelesbare kvartalsrapporten, for å kunne gjøre investeringsbeslutninger så snart informasjonen gjøres tilgjengelig i markedet.
Samtidig er det viktig å huske på forskjellen mellom informasjon som er nyttig for investorer, og informasjon som klassifiseres som innsideinformasjon. Etter klassisk økonomisk teori er kun prissensitiv informasjon ansett som nyttig informasjon. Det finnes imidlertid grunnlag for å påstå at denne distinksjonen blir for streng. Selv om finansregnskapet gir nyttig informasjon, særlig ved å gi en strukturert sammensetning av finansiell informasjon, er det ikke nødvendigvis innsideinformasjon. Eventuell innsideinformasjon som blir kjent gjennom regnskapsavslutningsprosessen, vil i mange tilfeller uansett måtte offentliggjøres før regnskapet er klart, i tråd med den løpende informasjonsplikten etter «Market Abuse Regulation (MAR)* Innsideinformasjon skal offentliggjøres så fort som mulig (artikkel 17, 1. ledd (596/2014)). Selv om det finnes unntaksregler i form av utsatt offentliggjøring, er det verdt å merke seg at tilfellene listet opp i ESMAs «Mar Guidelines on delayed disclosure» ikke inkluderer utsatt offentliggjøring av informasjon oppdaget under regnskapsavslutningsprosessen. Hvorvidt dette burde vært inkludert ble diskutert særlig hos FCA UK (se eksempelvis «Primary Market Bulletin 52» og «Technical Note 506.2»). (EFRAG, 2014) (Barker, Hendry, Roberts, & Sanderson, 2012).
Hvis lovgivers intensjon er at maskinlesbar informasjon skal være nyttig for investorer, bør det forventes at kravet på et tidspunkt utvides til øvrig periodisk rapportering. Det er noe krevende å forstå bakgrunnen for at det er viktigere at notene i årsrapporten merkes, enn at kvartalsrapportene merkes.
4.5 Kunstig intelligens – «XBRL is dead»
Det er vanskelig å unngå temaet kunstig intelligens (KI) ved vurdering av veien videre for XBRL og ESEF. Det er liten tvil om at kunstig intelligens vil få stor betydning for hvordan brukere innhenter og bearbeider finansiell informasjon. Det er imidlertid viktig å være bevisst at KI bygger på sannsynlighetsregning, noe som innebærer risiko for feil og hallusinering, særlig ved ny type informasjon i ny form.
Hvilke konsekvenser KI vil ha for XBRL og ESEF, ser ut til å dele seg i to overordnede perspektiv. Det ene perspektivet forventer at XBRL og ESEF kommer til å bli overflødig og unødvendig. Etter hvert som KI utvikles, skal informasjon kunne hentes ut og behandles på en effektiv måte med tilstrekkelig lav risiko, uten at informasjonen presenteres i et strukturert format. Et slikt syn tilsier at offentliggjøring i PDF skal være tilstrekkelig. I podkast-episoden med det treffende navnet «XBRL is dead» argumenteres det langt på vei for at dette er en reell mulighet.
Det andre perspektivet legger også til grunn at KI vil få stor betydning. Forskjellen er imidlertid troen på at teknologi leverer bedre resultat på et strukturert og organisert data- og informasjonsgrunnlag. Daglig leder i XBRL International beskrev dette med en treffende analogi: «AI without structured data is like a self-driving car without roads, maps and experience on the road. It might get somewhere, but not where you want to go» (XBRL International, 2025).
5. Oppsummering
Det er liten tvil om at ESEF er verdiskapende for brukerne. For dem som kun benytter den menneskelesbare rapporten, er denne fortsatt tilgjengelig på lik linje som før. Det maskinlesbare formatet åpner imidlertid for nye muligheter for dem som er i stand til å bruke det.
Om utstedernes kostnad overstiger brukernes nytte, er en mer krevende vurdering. Særlig for brukergruppene av investorer og långivere er det enkelte ulemper med nåværende løsning, særlig manglende merking av APM og øvrig periodisk rapportering. I tillegg viser høringsnotat fra ESMA at brukerne i begrenset grad har vært i stand til å utnytte blokkmerket noteinformasjon. Siden merking av noteinformasjon trolig er det området som er mest ressurskrevende for utsteder, er det ikke umulig å tenke seg at brukernes nytte ikke overstiger utstedernes kostnader på akkurat dette området.
ESEF videreutvikles på flere områder, noe som kan øke nytteverdien av elektronisk rapportering. Implementeringen av IFRS 18 vil åpne for finansiell informasjon mer egnet for elektronisk rapportering, inkludert MPMs. ESMAs høringsprosess vil trolig resultere i endringer som forebygger enkelte av ulempene ved blokkmerking av noteopplysninger. I tillegg er prosessen for å etablere et felles europeisk tilgangspunkt for selskapsinformasjon godt i gang («European Single Access Point», ESAP). Det blir derfor svært spennende å se på utviklingen innenfor elektronisk rapportering fremover.
Referanser
Anderson, T. (2004). Introducing XML – www.itwriting.com.
Baker, J. (2021). Lost in Translation? The transition from ASCII to Unicode with UTF-8 bridging the gap.
Barker, R., Hendry, J., Roberts, J., & Sanderson, P. (2012). Can company-fund manager meetings convey informational benefits? Exploring the rationalisation of equity investment decision making by UK fund managers.
EFRAG. (2014). The use of information by capital providers - Academic literature review.
ESMA. (2015). Consultation Paper on the Regulatory Technical Standards on the European Single Electronic Format (ESEF).
ESMA. (2015). Final Report – ESMA Guidelines on Alternative Performance Measures.
ESMA. (2016). Feedback Statement on the Consultation Paper on the Regulatory Technical Standard on the European Single Electronic Format (ESEF).
ESMA. (2024). Consultation Paper on the Regulatory Technical Standards (RTS) on the European Single Electronic Format (ESEF) defining marking up rules for sustainability reporting and revising the marking up rules for the Notes to the IFRS consolidated financial statements.
ESMA. (2024). Corporate reporting enforcement and regulatory activities .
ESMA. (2025). ESEF Reporting Manual – Update October 2025.
ESMA. (2025). ESEF XBRL Taxonomy 2024.
European Parliament. (2008). Resolution on a simplified business environment for companies in the areas of company law, accounting and auditing (2007/2254(INI)).
Ferrara, D. (2025). The Relationship Among SGML, HTML, and XML.
Gomez, E. A. (2020). The effect of mandatory disclosure dissemination on information asymmetry: Evidence from the implementation of the EDGAR system.
Harris, T. S., & Morsfield, S. G. (2012). An Evaluation of the Current State and Future of XBRL and Interactive Data for Investors and Analysts.
IFRS® Foundation. (2024). Effects Analysis - IFRS 18 Presentation and Disclosure in Financial Statements.
IFRS® Foundation. (2025). IFRS® Accounting Taxonomy 2025 - A view of the IFRS Accounting Taxonomy 2025 (Illustrating the early application of IFRS 18 Presentation and Disclosure of Financial Statements).
Ramin, K. P., & Prather, D. A. (2003). Building an XBRL IFRS Taxonomy.
SEC. (2005). Final rule – XBRL Voluntary Financial Reporting Program on the EDGAR System.
SEC. (2009). Final Rule - Interactive Data to Improve Financial Reporting.
The European Commission. (2007). Communication from the Commission on a simplified business environment for companies in the areas of company law, accounting and auditing (COM(2007)0394).
The European Council. (2000). Lisbon European Council 23 and 24 March 2000 - Presidency Conclusions.
The European Council. (2007). Brussels European Council – Presidency Conclusions - 8/9 March 2007 – (7224/1/07).
W3C. (2004). XML Schema Part 0: Primer Second Edition.
Waldt, D. (2004). XBRL: The Language of Finance and Accounting - www.xml.com.
Warren, P. (2022). Is your iXBRL slow to load? Here’s how to bring it up to speed.
XBRL International. (2013). Extensible Business Reporting Language (XBRL) 2.1.
XBRL International. (2013). Inline XBRL Part 1: Specification 1.1.
XBRL International. (2022). “Multiple reports, one document”: CoreFiling on multiple target documents in Inline XBRL.
XBRL International. (2024). Inline XBRL Block Tagging 1.0.
XBRL International. (2024). Report Package Technical FAQ.
XBRL International. (2025). How to use a single Inline XBRL document for multiple reports - Taxonomy Design Working Group.
XBRL International. (2025). Why AI needs XBRL.
XBRL International. (2026). XBRL Essentials.


